Codon:把 Python 编译成原生机器码的高性能编译器
阅读时间: 大约 12 分钟
Codon:把 Python 编译成原生机器码的高性能编译器
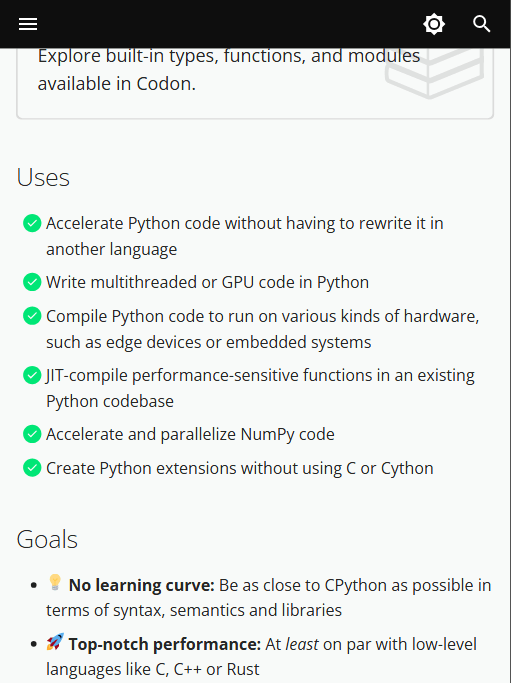
Python 的”慢”是它被吐槽了几十年的原罪——解释执行、动态类型、GIL,让它在数值计算、系统编程和低延迟场景里始终要让位给 C/C++、Rust。过去这些年,社区给的答案大多是”换语言”或”写 C 扩展”。由 Exaloop 公司开发并开源的 Codon 走了另一条路:保留 Python 的语法和绝大多数语义,但在提前编译(AOT)阶段做静态类型推断与 LLVM 优化,直接生成原生机器码。官方称单线程下相对原生 CPython 有 10–100 倍甚至更高的加速,性能”通常与 C/C++ 相当甚至更好”。
本文基于 Codon 官方文档(docs.exaloop.io,当前版本 v0.20.3)与其开源仓库,梳理它的工作机制、真实数据点,以及它在宣传口径之外的局限。
一、背景:Python 快不起来的根因
CPython 慢,不是因为解释器写得差,而是它的设计前提就是动态:
- 每个变量都是带类型标签的指针,每次操作都要做动态类型分派;
- 所有对象分配在堆上,引用计数带来额外开销;
- **GIL(全局解释锁)**让多线程无法真正并行执行 Python 字节码;
- 数值计算靠 NumPy 把循环下沉到 C,但 Python 层的循环本身仍然慢。
Codon 的思路是:既然 Python 的动态性是性能的敌人,那就在编译期把动态性消灭掉。它把 Python 源码当作一门带可选类型注解的静态语言来编译,借助 LLVM 做内联、循环优化、向量化,再原生支持多线程和 GPU。
二、它是什么:一门”重新想象过的 Python”
官方对自己的定位写得很直白:“Think of Codon as Python reimagined for static, ahead-of-time compilation, built from the ground up with best possible performance in mind.”(把 Codon 想象成一门为静态、提前编译而重新设计的 Python,从一开始就以极致性能为目标。)
它的五大目标(Goals)与两个明确的非目标(Non-goals)很能说明设计取舍:
目标:
- 零学习曲线——语法、语义、库尽量贴近 CPython;
- 顶级性能——至少对标 C/C++/Rust;
- 硬件支持——无缝支持多核、多线程(无 GIL)、GPU;
- 优化框架——能针对高层 Python 构造和库做优化;
- 互操作——与 Python 生态完整互通。
非目标(关键,容易被宣传忽略):
- 不是 CPython 的即插即用替代品:官方明确写了,“有些 Python 特性不适合静态编译,Codon 不支持它们”;
- 不发明新语法:尽量不加新关键字,仅在表达并行度时少量扩展。
三、技术机制:从 .py 到原生机器码
Codon 的编译管线大致是:Python 源码 → Codon 前端(带可选类型的静态解析)→ 自有的中间表示(IR)→ LLVM 优化后端 → 原生目标码。它提供几种产物形态:
| 命令 | 产物 | 用途 |
|---|---|---|
codon run file.py | 直接解释/运行 | 开发调试 |
codon run -release file.py | 开启优化后运行 | 性能验证 |
codon build -release file.py | 编译为原生可执行文件 | 部署、边缘设备 |
codon build -release -llvm file.py | 输出 LLVM IR | 嵌入/二次处理 |
几个关键机制值得单独说:
- 静态类型推断:Codon 在编译期做类型检查,不允许运行时猴子补丁、不允许往同一集合里塞不同类型——正是这些限制换来了”零运行时开销”。
- 无 GIL 的原生多线程:通过 OpenMP 实现,用
@par注解标注并行 for 循环,还能自动把循环里的total += 1变成原子归约以避免竞态。 - GPU 编程:提供
@gpu.kernel写 CUDA 风格核函数,或直接@par(gpu=True)把并行循环丢到 GPU。 - 自研 NumPy:不是绑定原生 NumPy,而是用 Codon 从零重写了一份 feature-complete 的 NumPy API,从而能做内联、算子融合、内存分配消除等优化,并与多线程/GPU 打通。
- Python 互操作:用
from python import matplotlib.pyplot as plt直接调原生 Python 包(需设置CODON_PYTHON指向 CPython 动态库);也能反过来用 JIT 装饰器把 Codon 函数嵌回 Python 工程。
四、官方给出的两个可核对数据点
官方没有放出完整的 benchmark 对比图表,文档里只给了两个具体例子,我们把它们列出来并标注口径:
| 测试 | CPython | Codon(-release) | 加速比 |
|---|---|---|---|
| 递归求 fib(40) | 17.98 s | 0.276 s | 约 65× |
| 蒙特卡洛估算 π(5 亿随机点) | 2.25 s | 0.43 s | 约 5.2× |
注意这两个数字差异巨大:递归 fib 是纯 Python 字节码热点,AOT 编译收益拉满;而蒙特卡洛算 π 用的是 NumPy 向量化运算,CPython 本身已经把循环下沉到 C,Codon 的优势只剩编译期优化,所以只快了 5 倍左右。这恰好揭示了”10–100 倍”这个区间是怎么来的——它高度依赖你的代码原本有多少时间花在 Python 层。
五、评测方法与口径批判
把官方宣传拆开看,有几处需要读者自己打折扣:
- “10–100ד是一个跨度极大的区间,不是一个数字。下限 10× 对应 NumPy 向量化代码,上限 100× 对应纯 Python 热循环。真实业务代码落在哪个区间,取决于 Python 层到底做了多少工作。
- **“性能与 C/C++ 相当甚至更好”**是在 fib 这类受控微基准上得出的。Codon 生成的是 LLVM 机器码,但它的标准库、运行时成熟度和 LLVM 后端的调优深度,与成熟 C++ 编译器(配合手写 SIMD/模板)相比并未在大型工程上验证。
- 对比基准是”vanilla Python”而非 Cython / PyPy / Numba。这三者是 Python 高性能化更主流的路线,官方文档没有把它们放进同一张对比表,读者无法判断 Codon 相对 Numba(同样 AOT/JIT、同样基于 LLVM)的增量价值。
- 测试环境未公开机型与编译器版本。两个例子只给了秒数,没写 CPU、是否热缓存、NumPy 是否启用 BLAS,可复现性有限。
六、语义偏差:用的时候最容易踩的坑
这是本文最想强调的一节——Codon 追求”像 Python”,但它不是 Python。官方在”Differences with Python”一页自己列出了若干静默行为差异:
int是 64 位有符号整数,而 CPython 3 的整数是任意精度。超大整数会溢出(需要用Int[N]指定位宽)。- 字符串是 ASCII,不是 CPython 的 Unicode 字符串——处理中文/emoji 要格外小心。
- 字典不保证插入顺序(CPython 3.6+ 是保证的)。
- 元组长度必须编译期已知,不能把任意长度的 list 转元组。
- 数值运算默认用 C 语义:除零直接抛异常等,与 CPython 不同。官方提供
-numerics=py旗标来贴合 Python 数值语义,但即便开了这个旗标,int仍然是 64 位——这是官方自己注明的局限。
也就是说,“零学习曲线”指的是语法层面;把一段能跑的 Python 代码原样丢给 Codon,在整数溢出、Unicode、字典顺序这些角落仍可能出现微妙的行为偏移。
七、优势与局限
优势:
- 语法贴近 Python,存量 Python 代码改动小即可获得原生性能;
- 真正无 GIL 的多线程与 GPU,这是 CPython/PyPy 都给不了的;
- 自研 NumPy 可被编译期优化并融合 GPU,适合科学计算热点;
- 可输出独立可执行文件,便于部署到边缘/嵌入式设备;
- 能通过
from python import复用整个 Python 包生态,避免孤立。
局限:
- 明确不是 CPython 替代品,动态特性(猴子补丁、动态类型集合、任意精度整数)受限;
- ASCII 字符串 + 64 位 int 的默认语义对中文/大整数场景不友好;
- 官方缺乏与 Numba/Cython/PyPy 的公开同场对比,加速宣称偏向 Python 纯循环;
- 生态年轻(v0.20.x),部分标准库尚未原生实现,需回退到
from python import; - 商业公司主导(Exaloop),长期路线图与开源治理需要持续观察。
八、谁该关注
- 科学计算 / HPC 工程师:想用 Python 写多线程或 GPU 代码、又嫌 Numba/Cython 门槛高的人;
- 边缘与嵌入式开发者:需要把数值脚本编译成单文件原生二进制、资源受限的场景;
- 有性能热点的 Python 团队:可以用 JIT 装饰器只加速热点函数,而不必重写整个工程;
- 不建议:重度依赖动态特性、Unicode 文本处理、或把它当作”换个解释器就能提速”的即插即用方案的人——这恰恰是官方画掉的非目标。