Cloudflare 开源 security-audit-skill:把 coding agent 变成带独立验证的安全审计员
阅读时间: 大约 11 分钟
Cloudflare 开源 security-audit-skill:把 coding agent 变成带独立验证的安全审计员
2026 年 9 月前后,Cloudflare 在 GitHub 开源了 security-audit-skill(MIT 协议,维护者 literally-dan)。它不是一个扫描器,而是一个 coding-agent skill——装到你的 Claude Code / Codex 这类 agent 里,一句「security audit this codebase」就会驱动一组相互隔离的子 agent 完成一次多阶段安全审计。官方坦白它的出身:这是 Cloudflare 内部那套「漏洞发现 harness」(见其博客《Build your own vulnerability harness》)的种子,内部已经长成跨团队、多阶段的系统,而这个 skill 是它「单仓起点」。本文基于仓库 README 做一手拆解。
一、它要解决什么问题:AI 找洞最大的坑是「幻觉确认」
让 LLM agent 做安全审计,最容易翻车的不是找不到洞,而是把臆测当成确认:agent 扫到一段代码,顺着猜测写一段听起来很像漏洞的结论,却没有可复现的证据链。security-audit-skill 的整套设计都在对抗这一点——核心机制是「找洞的人和验证洞的人永远不是同一个 agent」。
二、六阶段流程:从侦察到中立报告
官方把一次审计切成六个阶段:
- 侦察(Reconnaissance):画出架构、信任边界、输入面、既有证据,并产出确定性的
architecture.md与coverage-ledger.json(覆盖台账)。 - 覆盖驱动狩猎(Coverage-ledged hunting):从台账单元里分派互相隔离的 hunter,记录各自检查项,再用「coverage critics」找覆盖缺口。
- 候选验证(Candidate validation):把每个唯一候选交给一个全新的 verifier,它的任务是「证伪」而不是「证实」。
- 结构化输出(Structured output):把结论写成三类记录
confirmed/needs_validation/rejected到findings.json,并用report-schema.json校验。 - 独立记录验证(Independent record verification):再派全新 agent 复核最终源码级主张;凡是被替换过关键证据的,再给一个独立 verifier。
- 中立报告(Target-neutral reporting):从已验证记录与覆盖台账推导出
REPORT.md、FINDINGS-DETAIL.md、NEEDS-VALIDATION.md。
父流程在创建台账后、以及每次台账更新后跑 validate-coverage-ledger.cjs,在第四阶段及每次第五阶段证据替换后跑 validate-findings.cjs——两个都是零依赖 Node 校验器。
三类结论的口径被严格区分,这也是它区别于「agent 随口报洞」的关键:
| 结论类型 | 定义 |
|---|---|
confirmed | 拥有完整源码证据链 + 有界的可观测结果 |
needs_validation | 有一个尚未解决的确切事实,不给严重级别 |
rejected | 候选被证伪 |
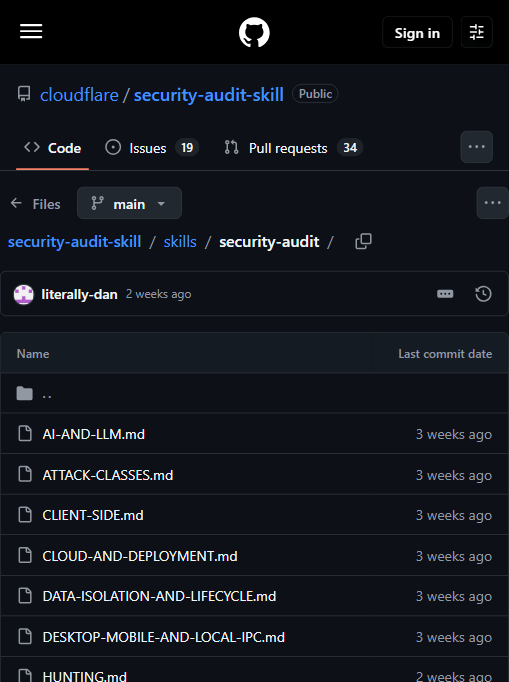
仓库把攻击面拆成了一长串专项提示词文件(见上图):AI-AND-LLM.md(prompt 注入、agent/tool、输出处理)、WEB-PROTOCOL-AND-AUTH.md(HTTP 请求 framing、缓存、认证协议)、CLIENT-SIDE.md(DOM 注入、消息信任、UI 重绘、原型链污染)、SUPPLY-CHAIN-AND-RELEASE.md、CLOUD-AND-DEPLOYMENT.md、MEMORY-SAFETY-AND-BINARY.md 等。这意味着它的覆盖面主要靠「预置攻击类清单」撑起来,而不是靠 agent 临场自由发挥。
三、硬性前提:没有沙箱,就不跑目标代码
这是官方写得最硬的一条。它要求 agent 所在环境具备 OS 级强制沙箱:禁止外部联网、使用清理过的 allowlist 环境、强制资源上限、只允许写入指定 scratch 路径。如果没有这些控制,工作流会主动把线索留在 needs_validation,而不是去执行目标代码。
安装与使用很简单:
npx skills add https://github.com/cloudflare/security-audit-skill \
  --skill security-audit
然后在代码仓库里对 agent 说「security audit this codebase」即可。不指定输出目录时,完整审计模式默认写到 ~/security-audit-skill/<repo-name>/run-<N>。
四、关键自陈数字与设计原则
官方给出的唯一量化结论是关于覆盖度的:
「在我们的测试运行中,单次运行找到的漏洞大约是多次重复运行累计找到漏洞的一半。」
这是一个需要正确解读的数字:它既说明「多跑几轮确实能补覆盖」(官方也因此设计成多次运行是叠加的——后续运行会利用既有台账找缺口、重验变更的源码),也说明不要指望一轮 agent 审计就全覆盖。它没有给出任何 CVE 数量、误报率或与商业扫描器的对比基准。
四条设计原则值得逐条读:
- 只确认已成立的边界失败:证据不足的线索留在
needs_validation,连具体未决事实都记下来; - 对抗性验证:找洞的 agent 永远不是验证洞的 agent;
- 严重级别 = 可能性 × 影响,而不是「偏离 checklist」;
- 纵深防御的缺口不算漏洞:如果 A 层已经挡住攻击,缺了 B 层只算 hardening 备注,不算洞。
五、客观分析:优势与局限
优势:
- 「隔离 hunter + 全新 verifier 证伪 + 机器可读 schema 校验」这套组合,正面针对 LLM 审计的幻觉问题;
- 结论分三档、
needs_validation不给 severity,避免了「agent 把猜测标成高危」的常见灾难; - 与 Cloudflare 内部真实 harness 同源,不是纯教学 demo;MIT 协议可直接用。
局限与官方口径偏差:
- 它是「单仓起点」,不是 Cloudflare 内部那套跨团队系统本身——内部能力远大于这个开源 skill,不要拿它的产出等同于 Cloudflare 的实际审计标准;
- 「单次找到约一半」意味着剩余约一半依赖重复运行与覆盖批评者,首轮报告必然有大量
needs_validation,把它当「一次性出结论」会失望; - 严重级别完全依赖 agent 对「影响」的判断,而它要求沙箱内可观测——在没有沙箱的环境里,大量线索会卡在
needs_validation,看起来「没找到洞」其实是没被允许验证; - 攻击面靠预置清单覆盖,对清单之外的新型攻击模式没有专门机制;
- 它产出的是文档(REPORT.md 等),不修复漏洞,也不替代人工安全 review。
六、谁该关注
- 已经在用 coding agent、想给代码库做一轮「带证据链」的安全自查的团队;
- 想研究「如何让多 agent 协作做可验证工作」的人——这个 repo 的角色分离与 verifier 设计是很好的样本;
- 有 OS 级沙箱、愿意多跑几轮并人工复核
needs_validation的工程团队。
对没有沙箱环境、指望「跑一次就出可修复漏洞清单」的人,这个 skill 目前给不出那样的结果——这既是它的克制,也是它的诚实。