Cloudflare D1:跑在 Workers 边上的 serverless SQLite SQL 数据库
阅读时间: 大约 11 分钟
Cloudflare D1:跑在 Workers 边上的 serverless SQLite SQL 数据库
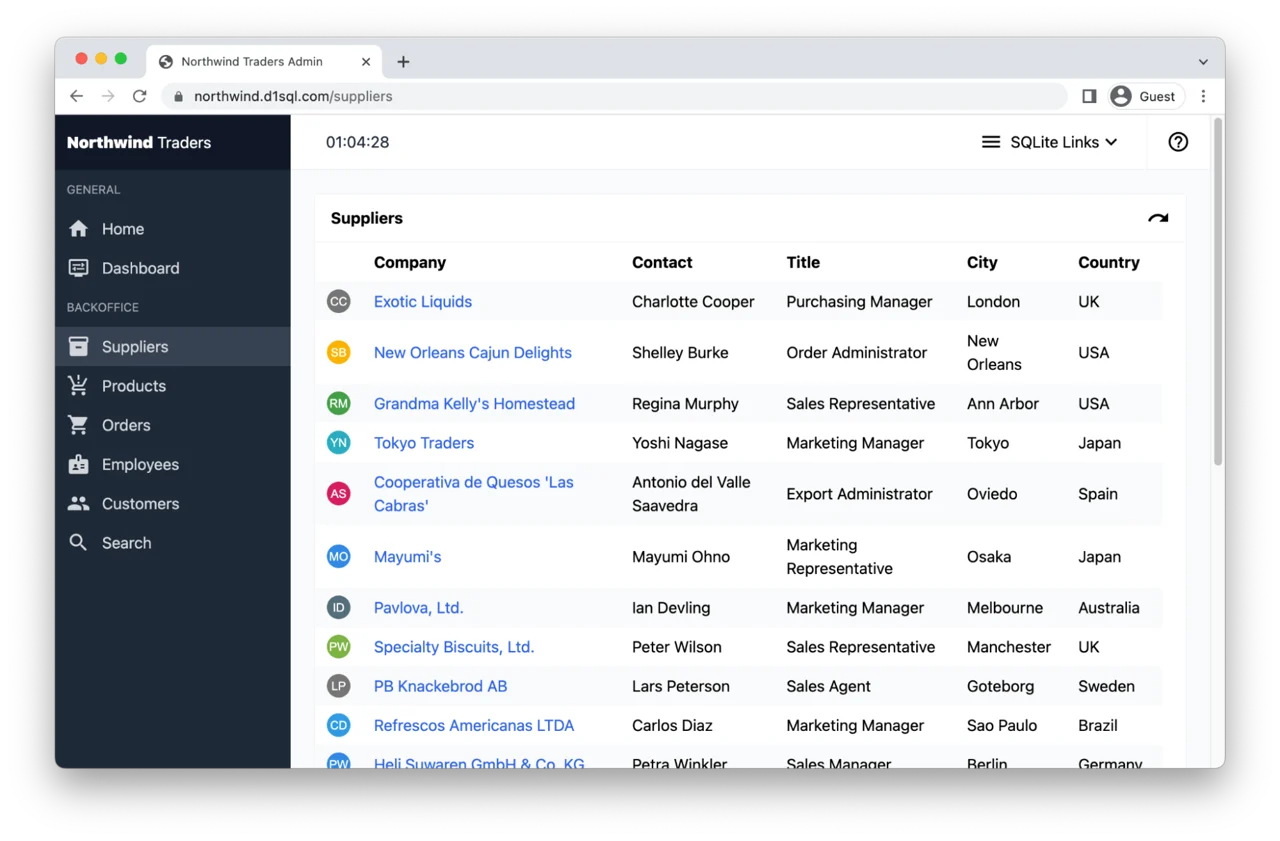
Cloudflare 在 2017 年推出 Workers(跑在网络边缘的函数计算)后很快意识到:真实应用是有状态的。于是他们陆续补齐了 KV、Durable Objects、R2,唯独一直缺一个大家最熟悉的东西——SQL 关系数据库。2022 年 5 月 11 日,Cloudflare 发布了自家的第一个 SQL 数据库 D1(作者 Rita Kozlov、Glen Maddern)。它的选择相当反直觉:不用 PostgreSQL、不用 MySQL,而是基于 SQLite。本文基于官方介绍博客与 2026 年 4 月更新的开发者文档,拆解它的架构、硬限制与定价口径。
一、背景动机:为什么是 SQLite
Cloudflare 的理由写得很直接:SQLite 是全球部署最广的数据库(每天数十亿设备在用),而且”SQLite 才是第一个 serverless 数据库”——它本来就字面意义上”不涉及一台服务器”。由于 Workers 本身跑在服务器与客户端之间、且理念上偏向客户端技术,SQLite 被认为是 Cloudflare 进入数据库领域最契合的起点。D1 的定位因此很明确:给 Workers/Pages 应用用的托管 serverless SQL 数据库,提供 SQLite 的 SQL 语义、内置容灾,以及 Worker 绑定与 HTTP API 两种访问方式。
二、技术机制:一个库 = 一个 Durable Object
按当前官方文档,D1 的运行模型有几个关键事实:
- 每个 D1 数据库由单个 Durable Object 承载,本质上是单线程的,一次只处理一个查询。官方原话是”each individual D1 database is inherently single-threaded, and processes queries one at a time”。请求过多时先排队,队列满就返回
overloaded错误; - 读副本(global read replication):D1 会在靠近用户的位置创建该数据的只读克隆并持续同步;每个读副本是一个独立的 Durable Object,上面的吞吐规则各自独立。文档导航里”Global read replication”仍标注 Beta;
- 批处理(batching):API 允许把多条语句放进一个数组,一次 HTTP 往返执行多条 SQL——这就是它做原子事务的方式(示例里同时扣用户余额、加商品销量);
- Time Travel:D1 的备份与按时间点恢复机制,付费版可恢复到最近 30 天内任意一分钟(免费版 7 天),每库每 10 分钟最多 10 次恢复;
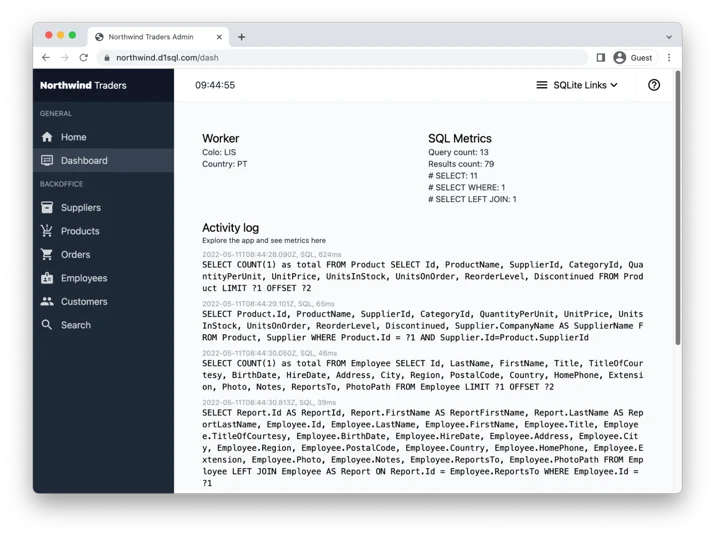
- 写操作需要跨多个位置持久化,因此写通常比读慢几毫秒;带合适索引的点读(如按主键
SELECT ... WHERE id=?)SQL 耗时可低于 1 毫秒。
三、关键数据:官方口径(2026-04 文档)
| 项目 | 付费版(Workers Paid) | 免费版(Free) |
|---|---|---|
| 每账户数据库数 | 50,000 | 10 |
| 单库最大尺寸 | 10 GB(且不可再调高) | 500 MB |
| 每账户存储上限 | 1 TB | 5 GB |
| Time Travel 时长 | 30 天 | 7 天 |
| 每次 Worker 调用查询数上限 | 1000 | 50 |
| 每表最大列数 | 100 | 100 |
| 单行 / BLOB 最大 | 2 MB | 2 MB |
| 单条 SQL 最大长度 | 100 KB | 100 KB |
| 单次查询绑定参数 | 100 | 100 |
| 单条查询最长耗时 | 30 秒 | 30 秒 |
| 导入文件上限 | 5 GB | 5 GB |
吞吐口径(官方给的粗略估算):单库单线程,吞吐直接取决于查询耗时——平均查询 1ms 时约 1000 QPS,平均 100ms 时约 10 QPS。
定价(按读取/写入行数计费,而非按查询次数):
| 计量项 | 免费版 | 付费版 |
|---|---|---|
| 行读取 | 500 万行/天 | 首 250 亿行/月免费,超出 $0.001 / 百万行 |
| 行写入 | 10 万行/天 | 首 5000 万行/月免费,超出 $1.00 / 百万行 |
| 存储 | 共 5 GB | 首 5 GB 免费,超出 $0.75 / GB·月 |
四、评测与口径偏差
- “1000 QPS”是有前提的外推:它建立在”平均查询 1ms、且都走索引点查”的理想情况下。一旦查询要扫更多行、或变成 100ms 级,单库吞吐立刻掉到 10 QPS 量级;
- 按”行读取”计费藏着陷阱:官方定义里,行读取统计的是查询扫描的行数,不是返回给 Worker 的行数。一张 5000 行的表做一次全表
SELECT *就算 5000 行读取;在未建索引的列上过滤,哪怕只返回几行,也要先扫大量行——账单和性能一起吃亏; - “可创建数千个数据库”是水平扩展叙事,不是单库变强:官方明确说 D1 是为”横向扩展到很多个 10GB 小库”设计的(每用户、每租户一个库),单库 10GB 是不可调高的硬上限。想要”一个大库扛大表”的思路在这里行不通;
- 读副本仍是 Beta:文档导航把全局读复制标为 Beta,生产可用性与一致性窗口需自行评估;
- 写要跨地持久化:写延迟因此高于读,这是 Durable Object 持久化模型的固有代价。
五、适用 / 不适用场景
适用: 已经跑在 Workers/Pages 上、想要一个”开箱即用、零运维”的关系型数据库;多租户/SaaS 场景,天然按租户切小库(每租户一个 D1);边缘读多写少、对附近读取延迟敏感的应用;配合 batching 做轻量事务、预算敏感(免费额度相当大方)的项目。
不适用: 单表/单库超过 10GB 的分析型或大事务负载;需要单库高并发写、复杂存储过程、窗口函数重度依赖 Postgres 特性的系统;对单库吞吐有强要求却不想做分库的团队——它的扩展方式是”拆成很多库”,不是”把一个库调大”。
六、客观分析:优势与局限
优势:
- 零运维、与 Workers 同栈:绑定即用,备份、Time Travel、读副本都是托管的,没有连接配置、没有连接池管理;
- 计费简单且免费额度慷慨:按行读/写与存储计量,无查询次数概念、无数据出口费,小规模几乎零成本;
- SQLite 语义友好:迁移本地 SQLite 文件、导入导出都很顺,开发体验接近”本地数据库直接上云”;
- 多租户切库模型干净:50,000 个库的额度,天然适合 per-tenant 隔离。
局限(官方自认或隐含):
- 单库 10GB 硬顶且单线程:这是最硬的边界,决定了它不是通用主数据库;
- SQLite ≠ 完整关系数据库:并发模型、高级特性与 Postgres/MySQL 有差距,不要期待企业级功能;
- 行读取计费需要刻意建索引:否则账单随全表扫描线性膨胀;
- 读复制仍在 Beta,写跨地持久化带来额外写延迟;
- 生态年轻:复杂运维、迁移、监控的工具链不如传统托管数据库成熟。
七、它意味着什么 / 谁该关注
D1 代表了 serverless 数据库的一条务实路线:不追求”一个数据库包打天下”,而是把 SQLite 这种最简单的引擎搬到边缘网络上,用 Durable Object 解决持久化、用读副本解决就近读、用”多小库”解决扩展。对已经身处 Cloudflare 生态、做中小规模或多租户应用的开发者,它是体验顺滑、成本可预测的选择;但如果你需要的是 PB 级、高并发写的核心业务库,D1 的 10GB 单库硬顶会立刻把你挡在门外。判断标准很简单:你的数据和并发,是不是能被拆成一堆”10GB 以内、单线程也够快”的小库——是,就很合适;不是,就该看 Postgres 类托管方案。