Cloudflare Containers:把容器塞进 Workers 的边缘 Serverless(公测)
阅读时间: 大约 11 分钟
Cloudflare Containers:把容器塞进 Workers 的边缘 Serverless(公测)
Cloudflare Workers 长期是个”轻量但有约束”的运行时:你跑的是 JS/WASM,语言、依赖体积、运行时长都受限。很多开发者想要”把整个应用跑在 Cloudflare 上,唯独这一个需要容器的组件不行”。2025 年 6 月 24 日,Cloudflare 正式推出 Containers 公测(paid plans),让你在 Workers 旁边跑真正的容器——媒体/数据处理、任意语言的后端、批量 CLI 工具都可以。Koala 还点出其野心:发布不久后 Cloudflare 就基于容器推出了给 LLM Agent 跑代码的沙箱服务。本文基于官方博客与控制台截图做分析。
一、背景:Workers 的边界在哪
Workers 的设计哲学是”毫秒级冷启动、全球边缘、按需扩到零”,代价是它不适合:需要原生二进制的库(如 FFmpeg)、需要长连接或长时运行进程、想用任意语言(Python/Go 原生运行时)、依赖体积大的场景。过去这类需求要么用 WASM 硬凑,要么放弃 Cloudflare 生态去别的地方。
Containers 的回答不是”取代 Workers”,而是在 Workers 旁边加一个更重的执行单元,由 Workers 代码来编排它。官方原话:“Use a Worker when you need to be ultra light-weight and scalable. Use a Container when you need more power and flexibility.”
二、机制:用 Workers 代码声明并拉起容器
它的开发体验非常”Cloudflare”——你在 Worker 里用一个 Container 类声明配置,然后 wrangler deploy:
export class MyContainer extends Container {
  defaultPort = 8080;
  sleepAfter = '5m';   // 5 分钟无请求就休眠
}

export default {
  async fetch(request, env) {
    const sessionId = new URL(request.url).pathname.split("/")[2];
    // 每个唯一 ID 拉起一个独立容器实例
    const instance = getContainer(env.CONTAINER_SANDBOX, sessionId);
    return await instance.fetch(request);
  },
};
配套 wrangler.jsonc 指定镜像(本地 Dockerfile 或镜像 URL)、max_instances、instance_type。关键行为:
- 按 ID 按需拉起:每个唯一 session ID 对应一个独立容器实例;
- 就近调度:Cloudflare 在全球网络里挑一个已预置好”就绪容器”的位置,把实例拉到离用户近的地方;
- 冷启动”只要几秒”:官方称初始容器启动 “takes just a few seconds”;
- 闲时休眠、缩到零:
sleepAfter超时后休眠,休眠期间不计费。
三、实例规格与定价
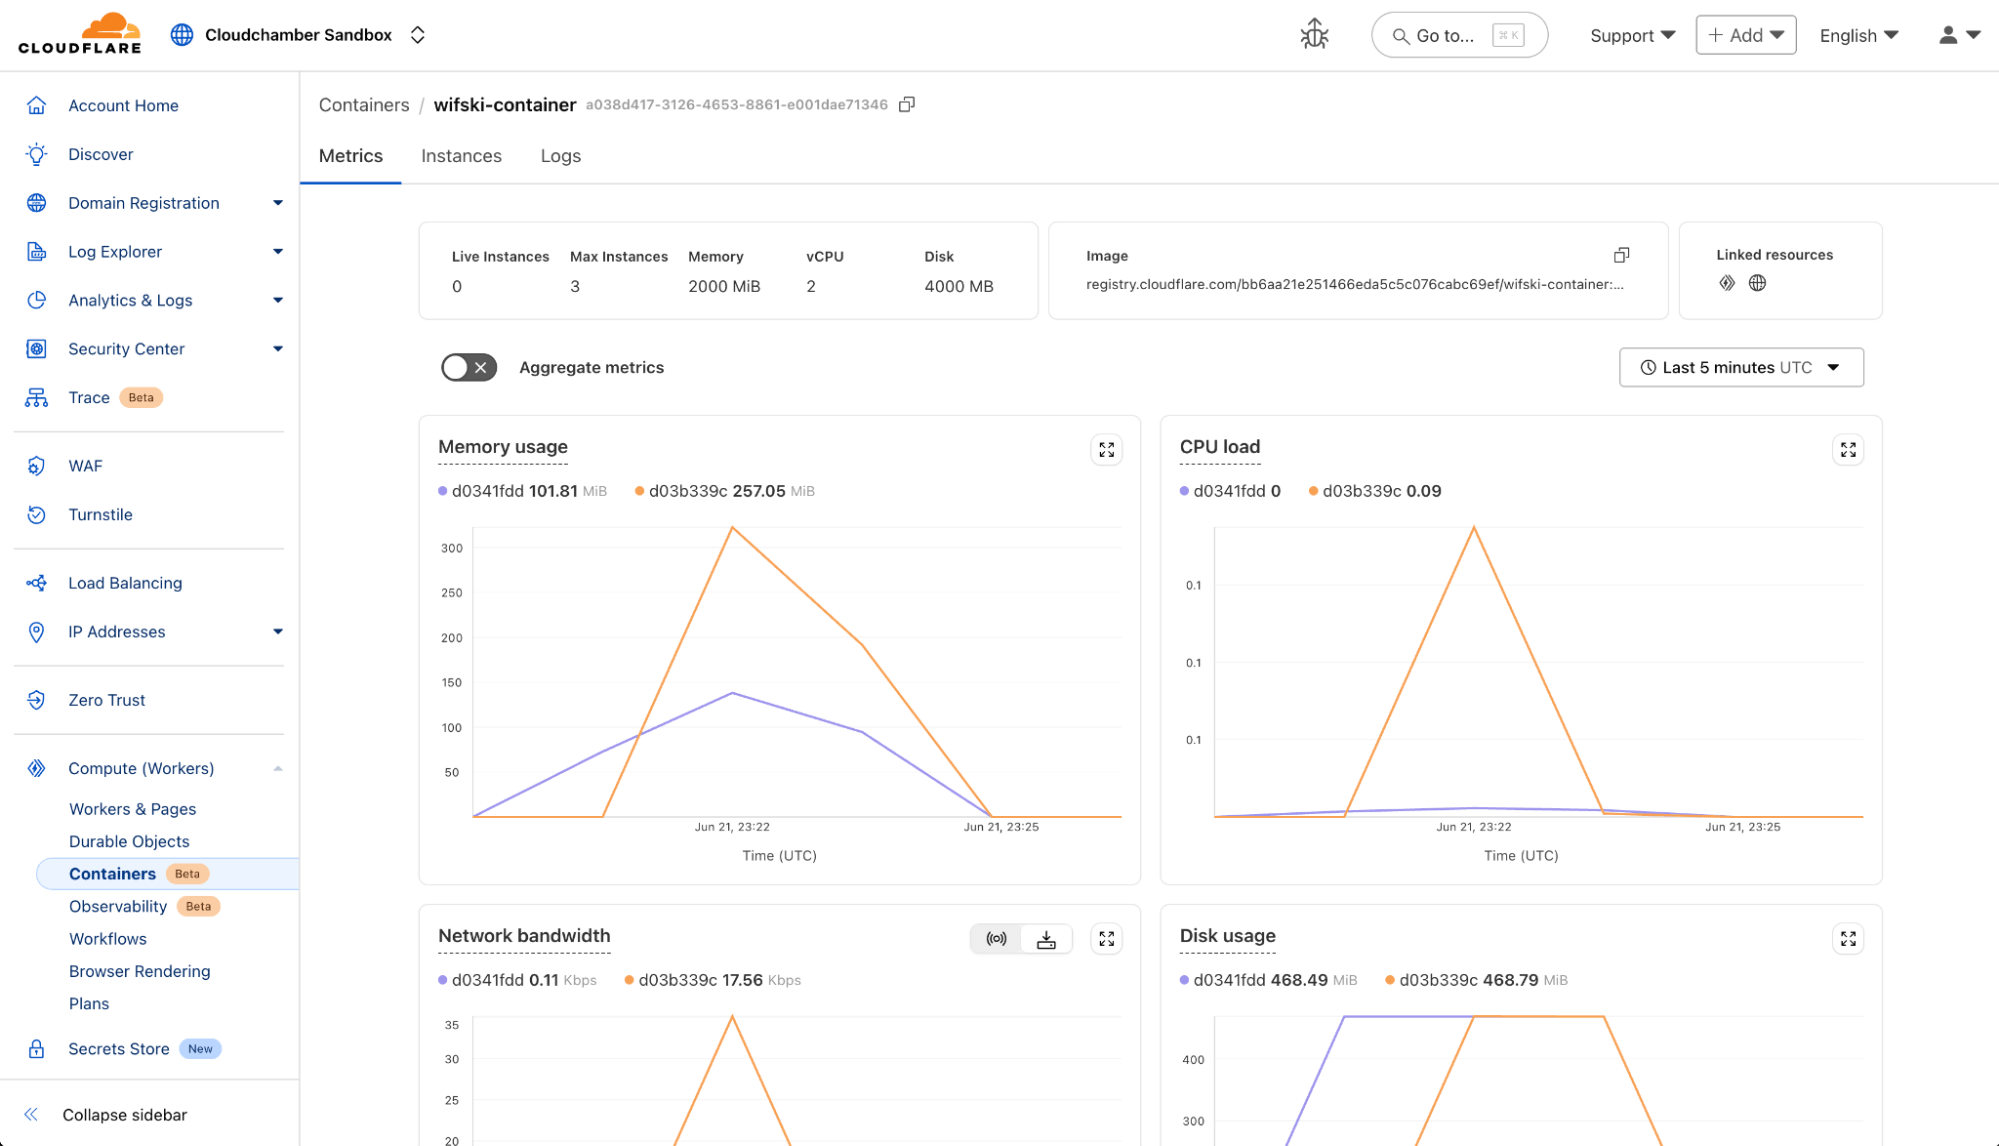
公测上线时提供三档实例(官方称后续会加更大规格):
| 实例 | 内存 | vCPU | 磁盘 |
|---|---|---|---|
| dev | 256 MiB | 1/16 vCPU | 2 GB |
| basic | 1 GiB | 1/4 vCPU | 4 GB |
| standard | 4 GiB | 1/2 vCPU | 4 GB |
计费方式是按容器活跃运行的每 10ms 收费,请求到达或手动启动才开始计费,休眠后停止:
| 资源 | 单价 | 每月 Workers Standard 包含额度 |
|---|---|---|
| 内存 | $0.0000025 / GiB-秒 | 25 GiB-小时 |
| CPU | $0.000020 / vCPU-秒 | 375 vCPU-分钟 |
| 磁盘 | $0.00000007 / GB-秒 | 200 GB-小时 |
出站流量:北美/欧洲 $0.025/GB(含 1 TB);澳新/台/韩 $0.050/GB(含 500 GB);其他地区 $0.040/GB(含 500 GB)。
四、它和生态怎么联动
官方强调 Containers 与整个开发者平台组合使用:用 Durable Objects 管状态、Workflows/Queues/Agents 编排复杂行为、R2 存容器产生的数据或媒体。给出的玩法示例包括:用 FFmpeg 在容器里把视频转 GIF、把容器当 cron 任务跑、静态前端配容器化后端、甚至跑一个 Claude Code Agent。这正是 Koala 说的”为 LLM Agent 调用代码提供安全沙箱”的落点——每个用户一个隔离容器、全球就近拉起、闲时休眠省钱。
五、评测方法批判:公测阶段必须认清的边界
- 实例偏小、总量有硬顶。 最大档也才 4 GiB / 0.5 vCPU;官方当前限制是并发总量 40 GiB 内存 / 40 vCPU。这不是给重型后端、数据库、大模型推理准备的,它适合”大量小而短的隔离容器”。
- “几秒冷启动”是相对的。 和 Workers 的毫秒级相比,容器几秒启动仍慢一个量级;对交互式沙箱够用,对超低延迟 API 不行。
- 按 10ms 活跃计费的两面性。 突发流量、闲时缩到零非常划算;但如果你跑的是 7×24 常驻服务,持续计费会比预留 VM 贵——它的经济学是为”弹性/突发”优化的。
- 无持久卷假设。 容器休眠/销毁后本地磁盘不保证持久,状态要靠 R2/Durable Objects/KV;把它当持久主机用会碰壁。
- 公测 + 付费套餐门槛。 当前仅付费计划可用,规格、限额、定价都可能调整;官方也明说”更大规格、全球自动扩缩容、容器 exec、容器↔Worker 通信”都是 roadmap 而非现成能力。
六、优势与局限
优势:
- Workers 级别的全球体验:一条
wrangler deploy、Region:Earth全球部署,免去多区域配置; - 按 ID 隔离 + 就近拉起 + 闲时休眠:天然适合多租户沙箱、AI Agent 代码执行;
- 与 Workers 生态原生组合:DO/Workflows/Queues/R2 一脉打通;
- 按 10ms 计费、缩到零:突发负载成本可控。
局限:
- 规格小、总量限额低(40 GiB/40 vCPU),不适合重负载;
- 持久化要靠外部存储,容器本地盘非持久;
- 公测阶段:仅付费套餐,能力与定价仍在变动;
- 不是 K8s/VM 的替代:没有成熟的有状态编排、持久卷、自定义网络。
七、适合谁
- AI Agent / 代码沙箱平台:每个会话一个隔离容器、全球就近、闲时休眠,正中靶心;
- 边缘媒体/数据处理:如 FFmpeg 转码,Workers 跑不了的原生二进制;
- 想”全栈上 Cloudflare”的小团队:一个 Worker 前端 + 一个容器后端,统一部署体验;
- 不适合:常驻高吞吐数据库、内存大于 4 GiB 的计算、需要持久卷与复杂网络编排的传统后端。
八、它意味着什么
Cloudflare Containers 的战略信号很清楚:边缘 Serverless 正在从”只跑轻量函数”走向”轻量函数 + 按需容器”的混合体。它没有去和 K8s 硬碰硬,而是把容器塞进 Workers 的全球调度与计费模型里,瞄准的是 AI 时代大量出现的”短生命周期、强隔离、全球分布”的负载——尤其是 Agent 代码沙箱。对开发者而言,它给了一个新选项:当 Workers 的约束挡路时,你不必离开 Cloudflare,只需多声明一个容器。但请记住公测期的硬顶:它现在是”成千上万个小容器”的平台,还不是”少数几个大服务器”的家。