Claude Code 性能透明性之争:一份 23 万次工具调用日志分析与 Anthropic 的三份溯源
阅读时间: 大约 15 分钟
Claude Code 性能透明性之争:一份 23 万次工具调用日志分析与 Anthropic 的三份溯源
2026 年 4 月 2 日,用户 stellaraccident 在 anthropics/claude-code 仓库发起高关注 issue #42796《[MODEL] Claude Code is unusable for complex engineering tasks with the Feb updates》。作者没有停留在抱怨,而是挖掘了自己 1 月 30 日至 4 月 1 日的会话日志,提交了一份基于 17,871 个思维块、234,760 次工具调用的定量分析,主张二月推送的”思维内容遮蔽”(redact-thinking-2026-02-12)与可测量的质量退化精确同步。issue 最终收到 583 条评论并被关闭;4 月 23 日 Anthropic 发布官方 post-mortem,承认三份独立改动导致问题。本文以 issue 原文、维护者回复与官方复盘三方互证,拆解这场”推理成本优化 vs 输出质量”的争论。
一、背景:一个重度多 Agent 用户的回归观察
作者的工作环境是 50+ 并发 Agent 会话做系统编程(C、MLIR、GPU 驱动),单会话自主运行 30 分钟以上,项目 CLAUDE.md 超过 5,000 词。作者称在质量较好的时期(1 月 30 日–2 月 12 日),两个 PR 一个周末合并了 191,000 行代码;进入 3 月后,同样的人类投入(2 月 5,608 条提示 vs 3 月 5,701 条)却出现贸然编辑、未读先改、过早停止、推卸责任等行为,被迫关停整个并发舰队退回单会话监督模式。
二、作者的核心证据链
作者分析了 ~/.claude/projects/ 下四个项目(iree-loom、iree-amdgpu、iree-remoting、bureau)的 6,852 个会话 JSONL 文件。
1. 遮蔽时间线与回归同步。 思维块可见比例从 3 月 5 日的 98.5% 降到 3 月 7 日 75.3%,3 月 8 日降至 41.6%(遮蔽首次过半,58.4%),3 月 10–11 日超过 99%,3 月 12 日起 100% 遮蔽。作者称独立的质量回归报告恰好出现在 3 月 8 日。
2. 思维深度在遮蔽之前已下降。 作者利用思维块 signature 字段与内容长度 0.971 的 Pearson 相关(7,146 个配对样本)反推:基线(1/30–2/8)中位思维约 2,200 字符,2 月下旬约 720(-67%),3 月 1–5 日约 560(-75%),完全遮蔽后约 600(-73%)。也就是说,深度在遮蔽开始前就已经掉了三分之二,遮蔽只是让用户”看不见”。
3. 行为指标量化(18,000+ 条提示独立计算):
| 指标 | 3 月 8 日前 | 3 月 8 日后 | 变化 |
|---|---|---|---|
| Stop hook 违规(懒惰守卫) | 0 | 173 次/17 天 | 0 → 约 10 次/天 |
| 用户提示中的挫败信号 | 5.8% | 9.8% | +68% |
| 需纠正的推卸责任 | 6 | 13 | +117% |
| 每会话提示数 | 35.9 | 27.9 | -22% |
| 出现推理循环(5+)的会话 | 0 | 7 | 0 → 7 |
4. 工具使用从”研究优先”退化为”编辑优先”。 234,760 次工具调用中,读:写比从良好期的 6.6 降到退化期的 2.0(研究量减少 70%);未读即改的编辑占比从 6.2%(72 次)升到 33.7%(5,028 次);整文件 Write 占变异操作的比例从 4.9% 翻倍到 10.0%(3 月下旬 11.1%);每千次工具调用的用户打断从 0.9 升到 11.4(约 12 倍);推理反转词(“oh wait""actually”)从 8.2/千次升到 26.6/千次。
5. 成本侧的反常。 作者按 Bedrock Opus 价格(输入 $15/MTok、输出 $75/MTok、缓存读 $1.50、缓存写 $18.75)估算:去重 API 请求 2 月 1,498 次 → 3 月 119,341 次;总输入 120.4M → 20,508.8M tokens;输出 0.97M → 62.60M;估算成本 $345 → $42,121,而订阅费始终是 $400/月。
三、维护者 Boris Cherny 的官方回复(4 月 6 日)
Claude Code 维护者 bcherny(COLLABORATOR)在 issue 中做了两点核心澄清:
redact-thinking-2026-02-12是纯 UI 改动:beta 头只是把思维从界面隐藏,因为多数用户不看;它不影响思维本身、不影响思维预算、也不影响底层扩展推理。开启它是为了省掉思维摘要以降延迟,可用showThinkingSummaries: true退出。他指出:分析本地存档 transcript 时看不到原始思维,很可能正是这一点扭曲了分析结论。- 2 月确有两项会影响表现的改动:2 月 9 日 Opus 4.6 上线默认 adaptive thinking(模型自行决定思考时长,可用
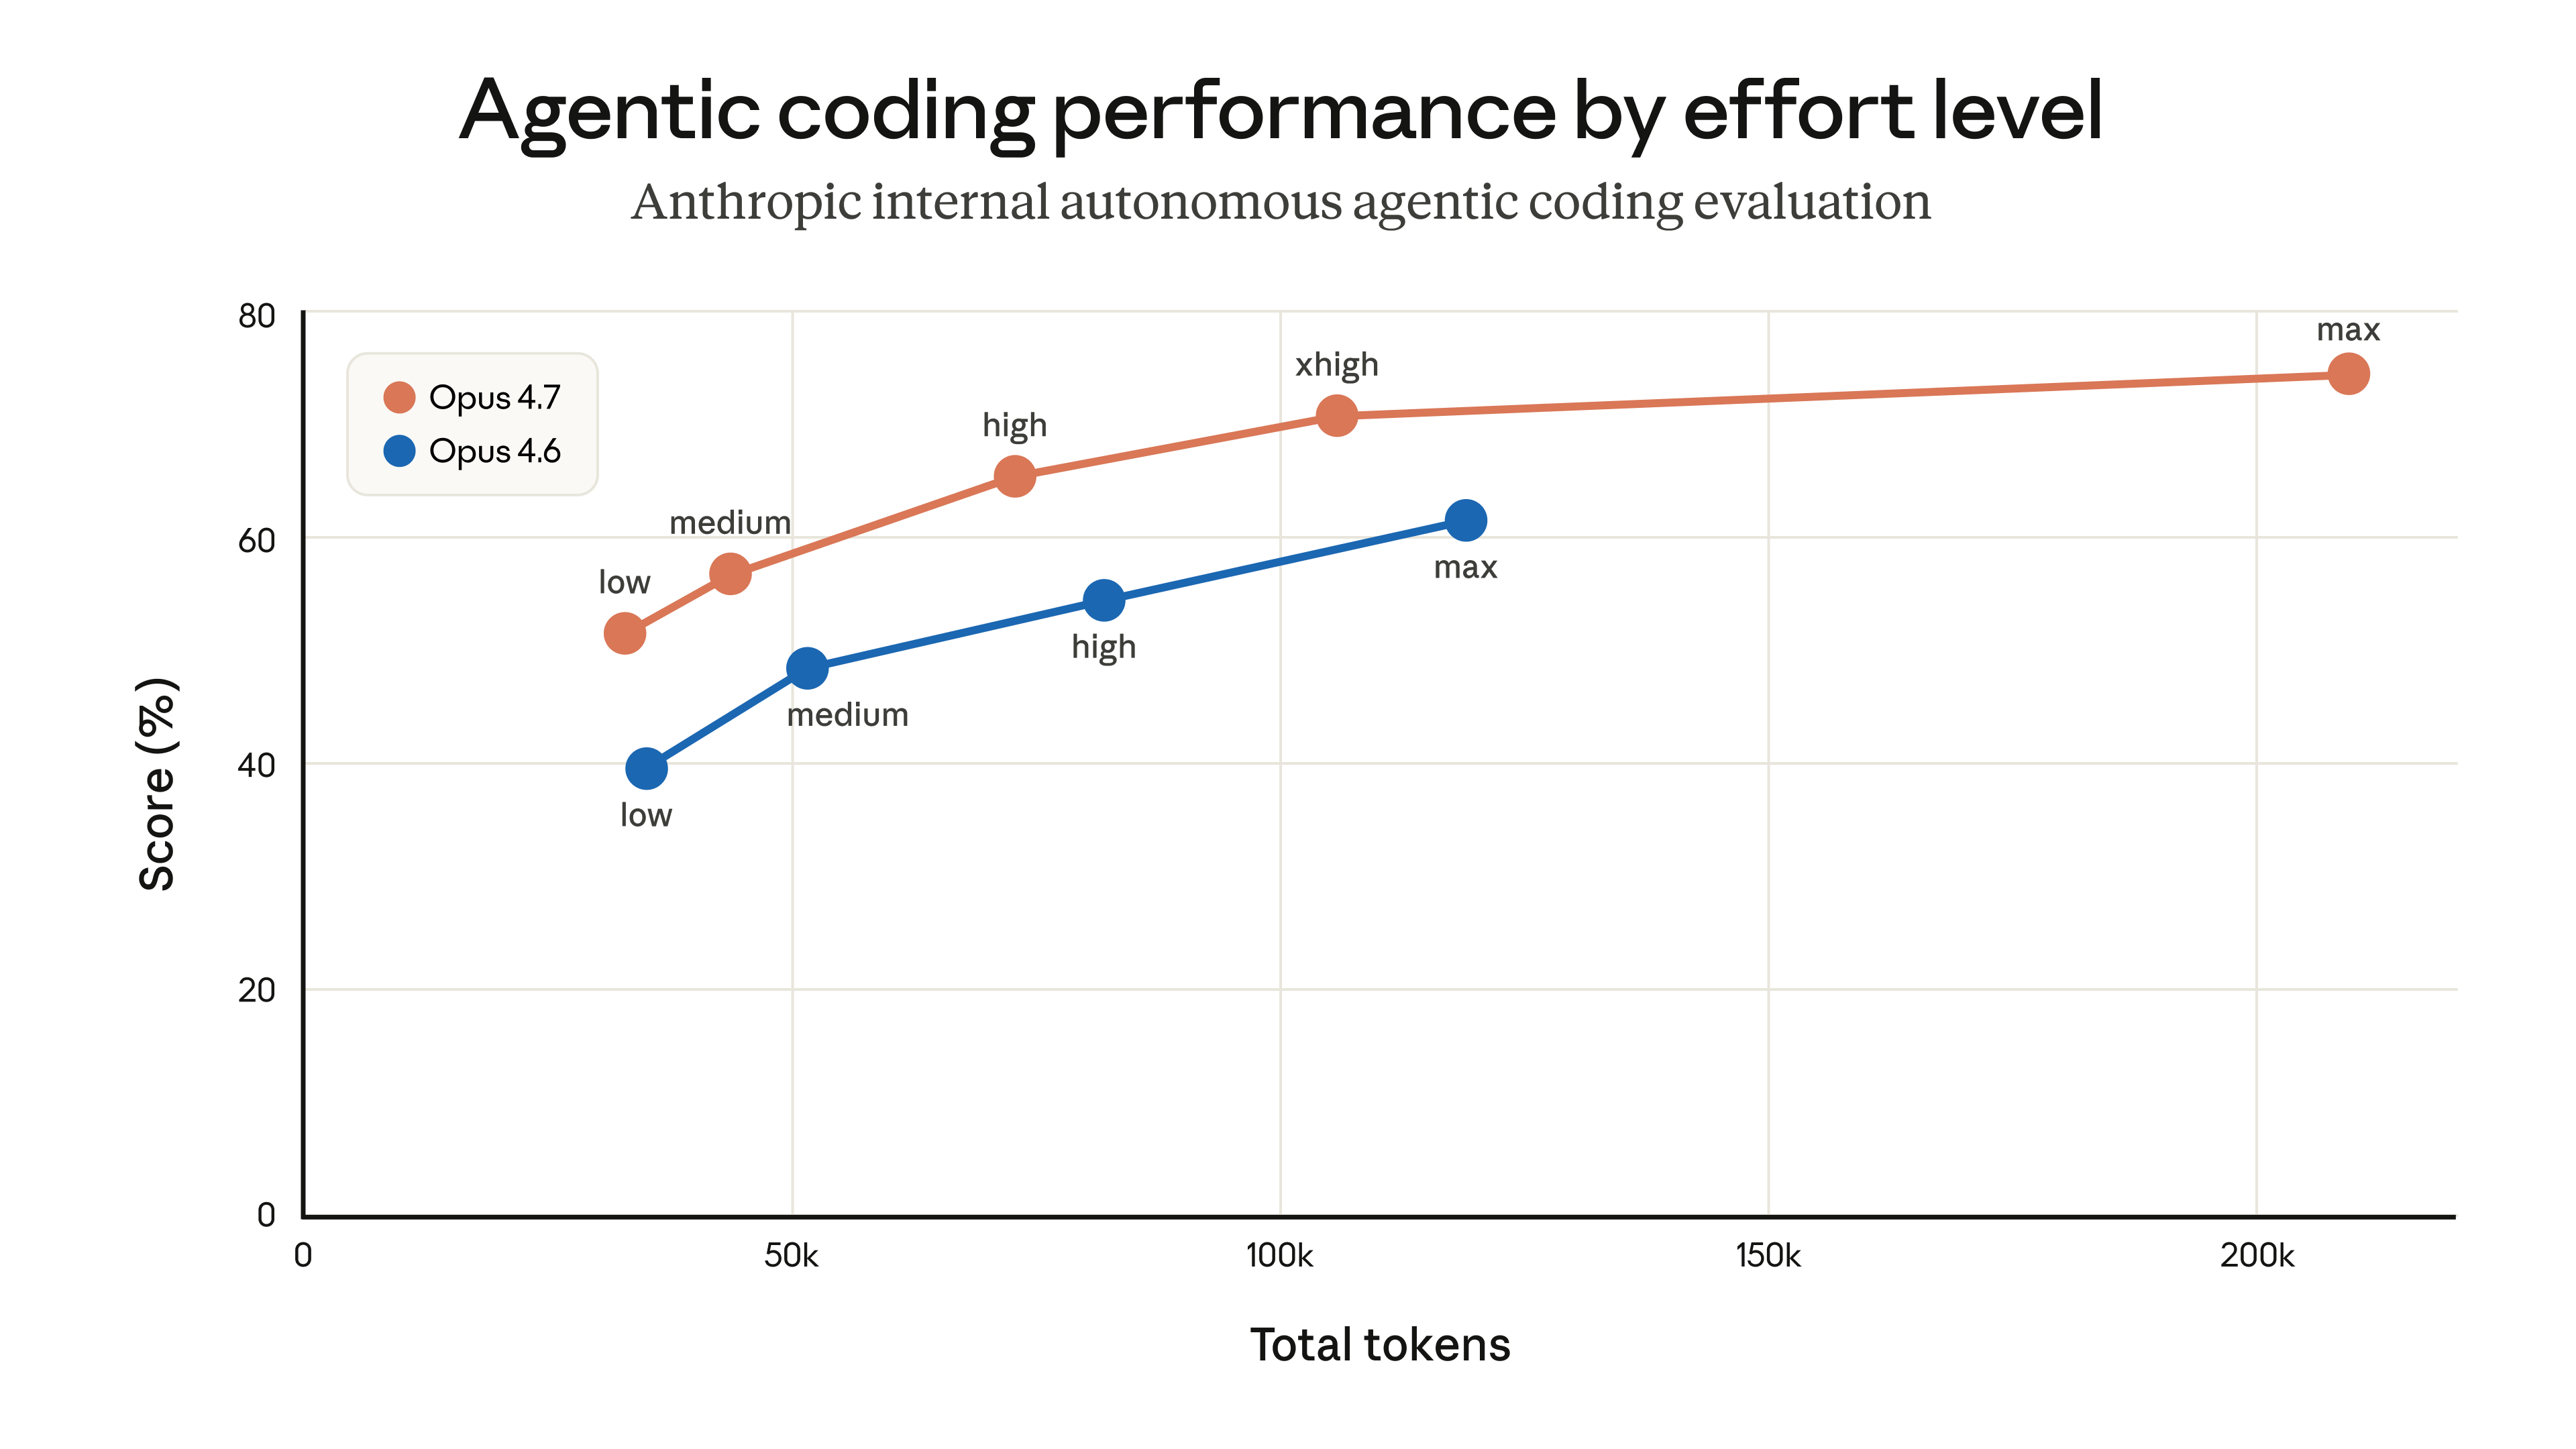
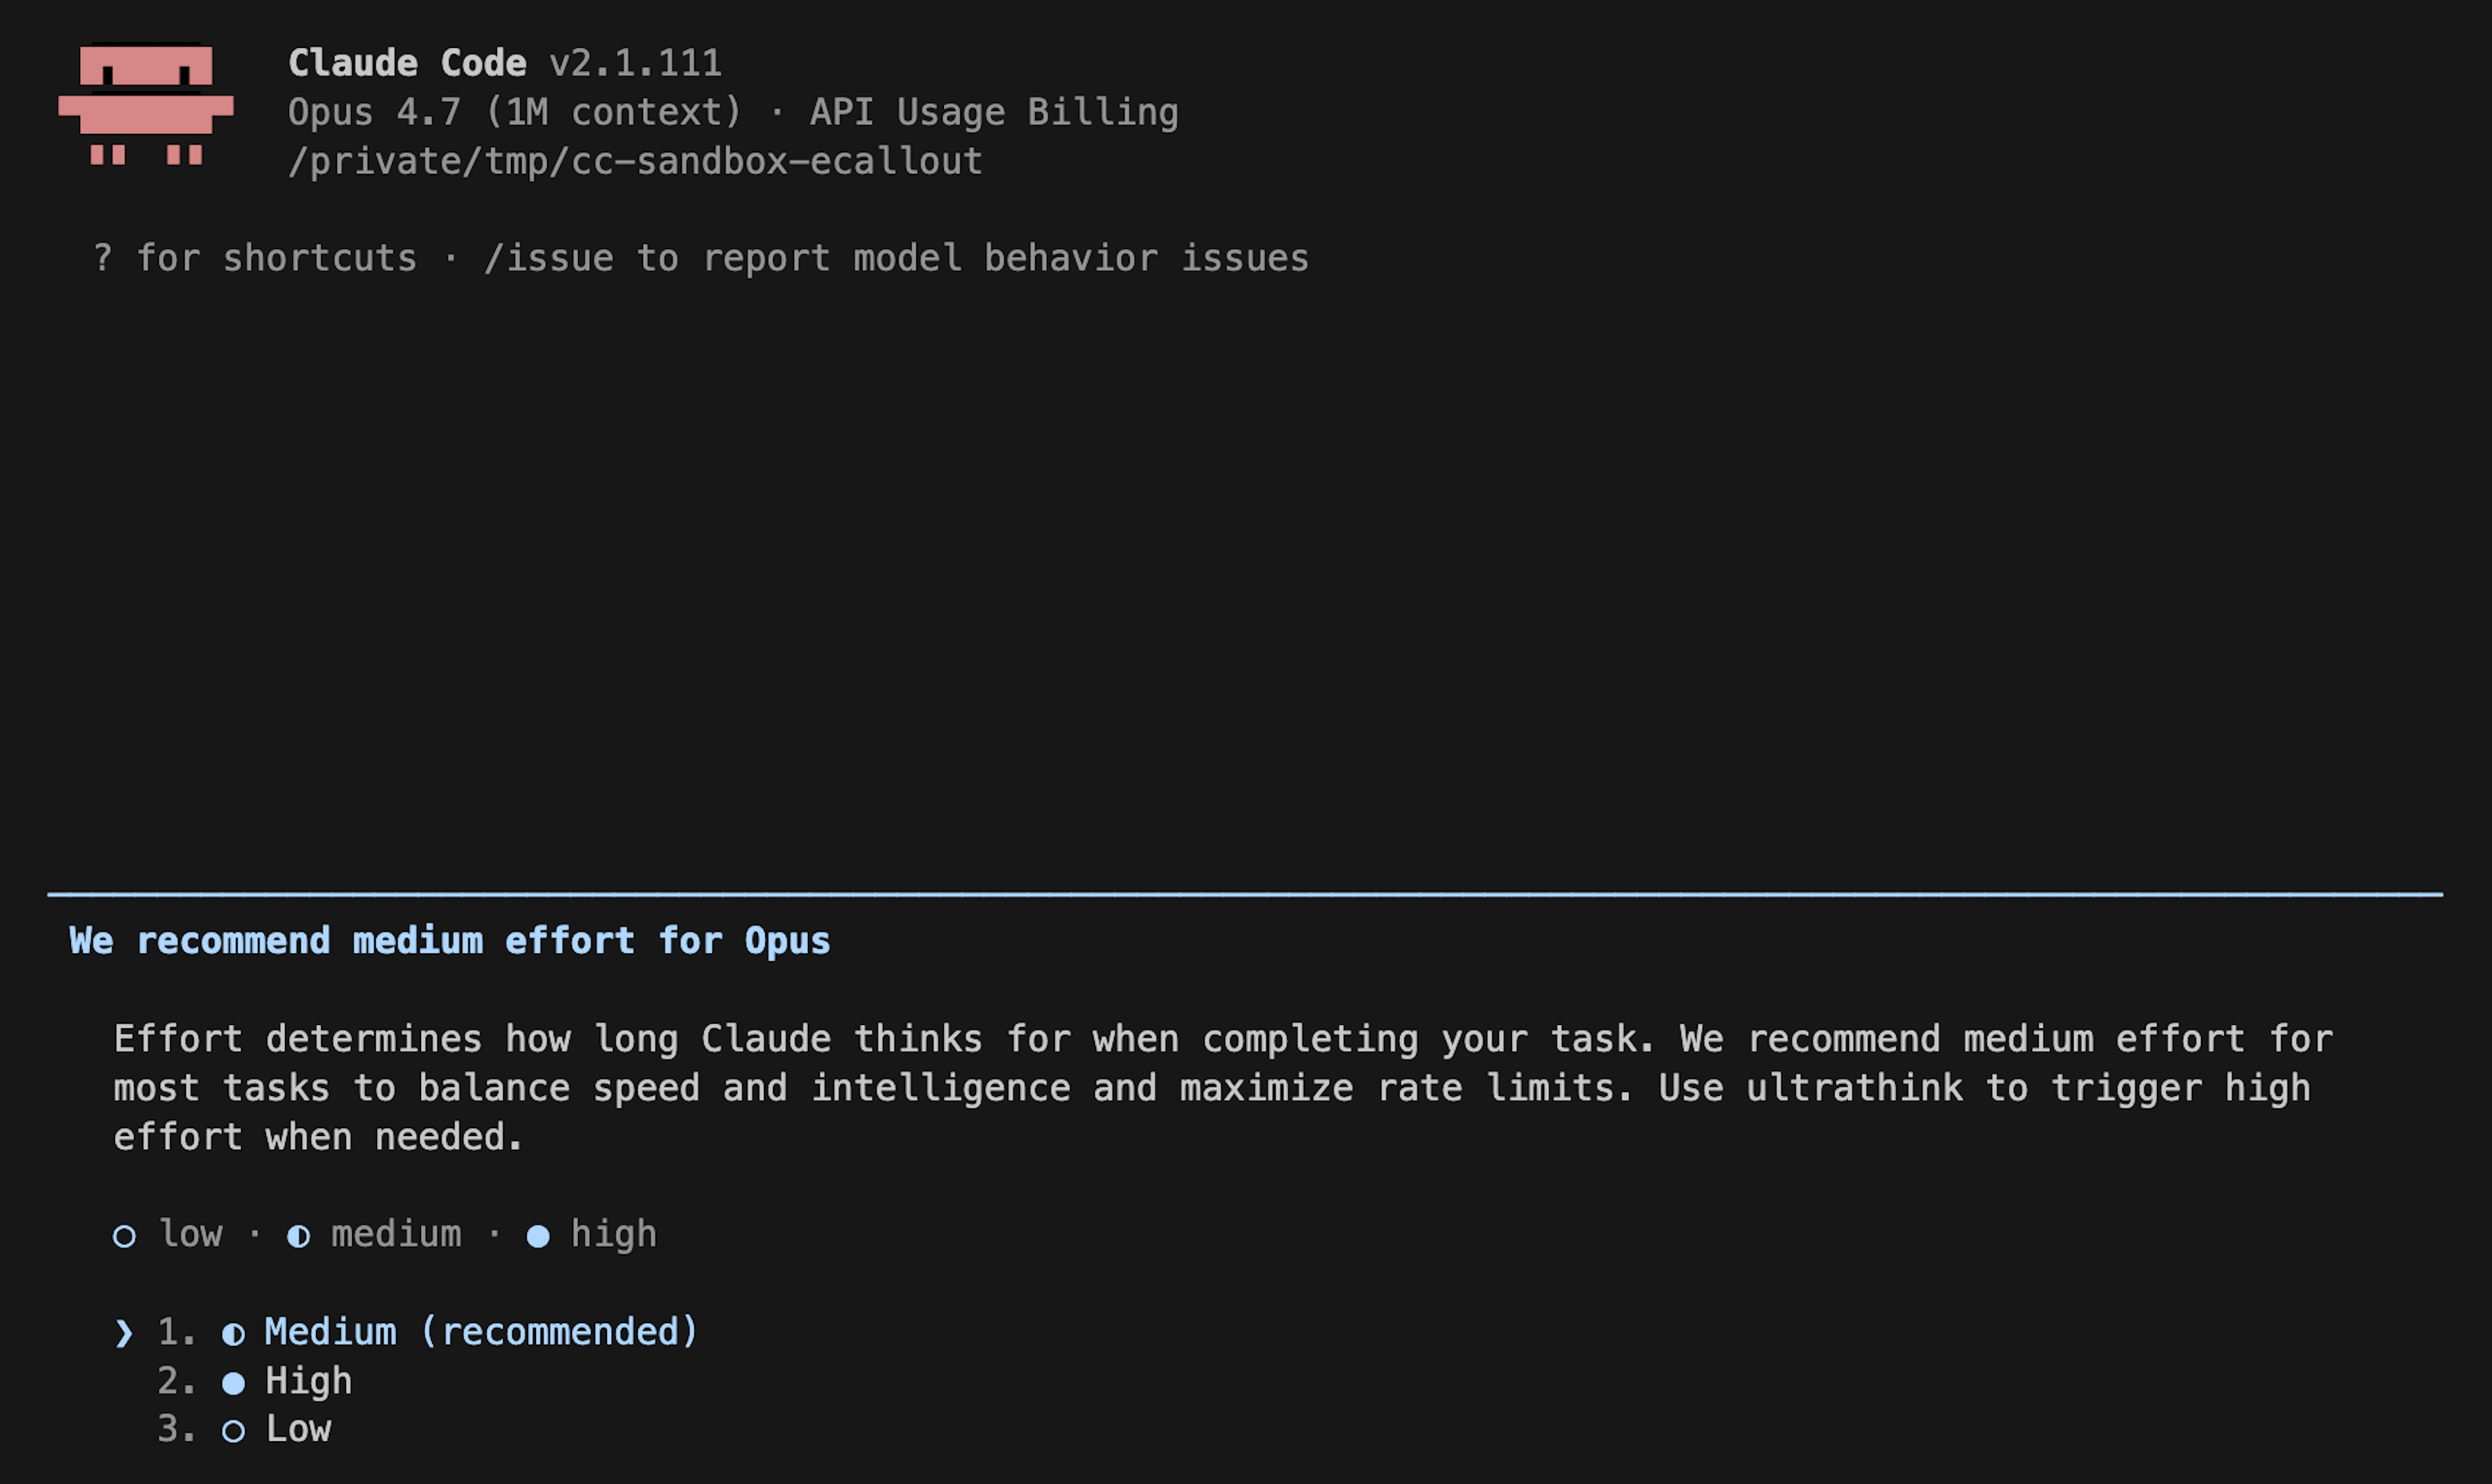
CLAUDE_CODE_DISABLE_ADAPTIVE_THINKING退出);3 月 3 日 Opus 4.6 默认调到 medium effort(85),官方称这是智能-延迟-成本曲线上对多数用户的甜点,可用/effort high、/effort max或 ULTRATHINK 关键词提升。
他同时否认当时知悉其他内部改动导致该问题,并要求作者用 /bug 提供 transcript 以便定位;另一条评论澄清:本地 transcript 里的重复记录是磁盘存档 bug(同一请求被记 5 次),并非 5 倍计费,该问题下次发布修复,恢复时缓存重建问题在 v2.1.90 修复。
四、4 月 23 日官方 post-mortem:三份独立改动
4 月 24 日 bcherny 在 issue 置顶了官方复盘《An update on recent Claude Code quality reports》(4 月 23 日发布,问题于 4 月 20 日 v2.1.116 全部解决;API 与推理层未受影响)。Anthropic 追溯到三份分别上线、错峰生效、叠加后看似”普遍且不一致退化”的改动:
| # | 上线日期 | 改动 | 问题 | 修复/回滚 | 影响模型 |
|---|---|---|---|---|---|
| 1 | 3 月 4 日 | 默认 reasoning effort 从 high 改为 medium,以消除 high 模式偶发的超长尾延迟(UI 假死) | 官方承认”这是错误的权衡” | 4 月 7 日回滚;现 Opus 4.7 默认 xhigh,其余模型默认 high | Sonnet 4.6、Opus 4.6 |
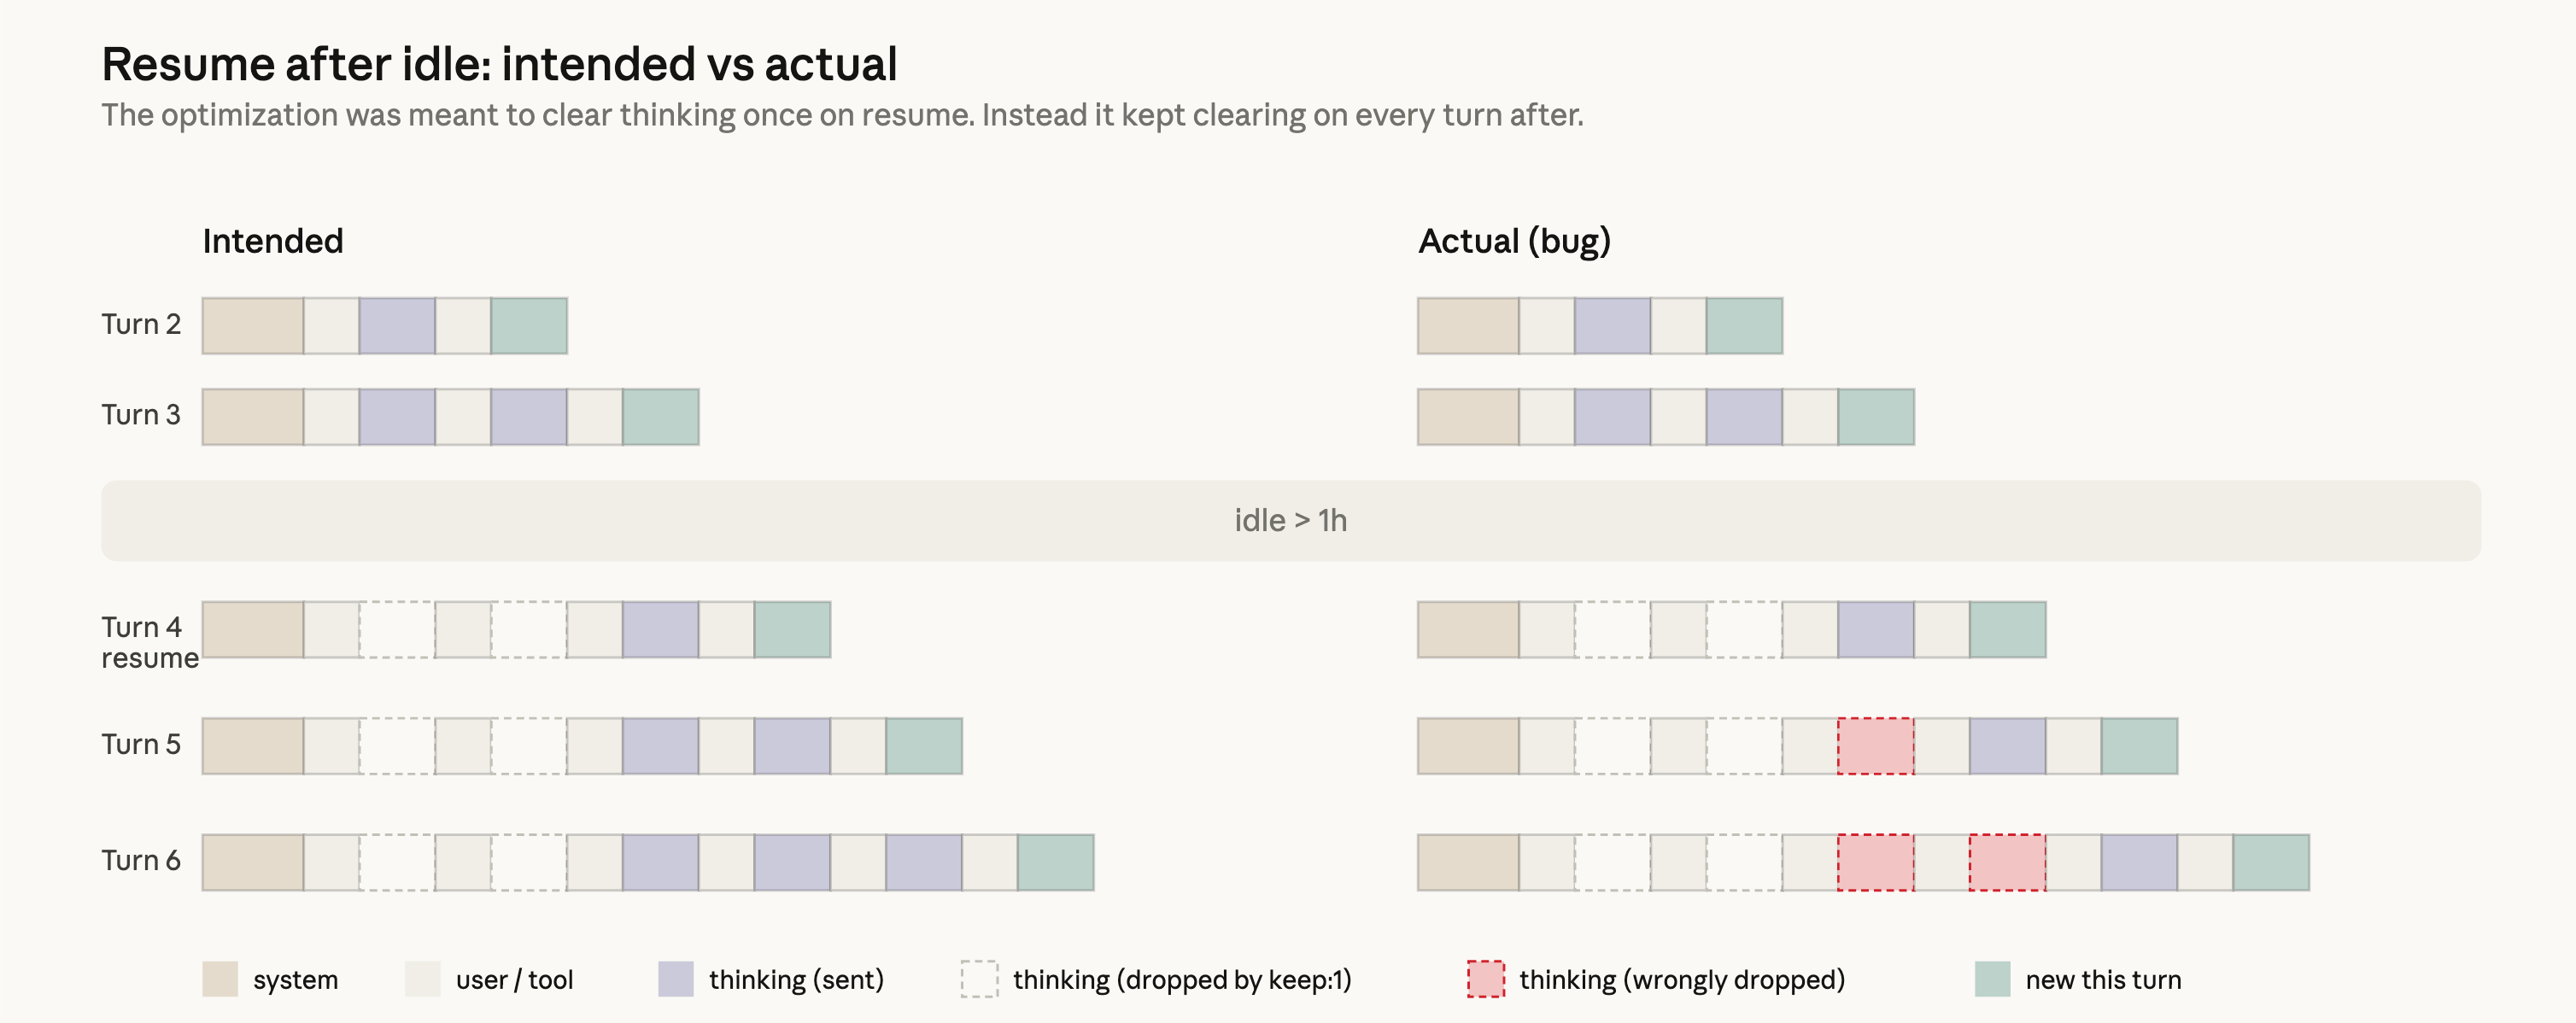
| 2 | 3 月 26 日 | 闲置超 1 小时恢复时用 clear_thinking_20251015 头 + keep:1 清一次旧思维以降缓存成本 | bug:之后每一轮都只保留最近一块思维,造成健忘、重复、奇怪工具选择,也推高缓存未命中 | 4 月 10 日 v2.1.101 修复 | Sonnet 4.6、Opus 4.6 |
| 3 | 4 月 16 日 | 系统提示加”工具调用间文字 ≤25 词、最终回复 ≤100 词”以压 Opus 4.7 的啰嗦 | 与其他提示叠加后损伤编码质量;更宽评测集上一次 ablation 显示 4.6/4.7 均掉 3% | 4 月 20 日回滚 | Sonnet 4.6、Opus 4.6、Opus 4.7 |
官方同时宣布 4 月 23 日重置所有订阅者用量额度,并承诺对系统提示改动加 per-model 评测、ablation、soak 期与灰度。
五、方法论批判:这份日志分析哪里站得住,哪里有偏差
站得住的部分: 作者把”感觉变笨”落成了可机器读取的信号(stop hook 违规、读:写比、打断率、词频),这在产品方只看汇总评测时非常有价值;事后 post-mortem 证实”3 月初质量确实退化”这一总体判断成立。
口径与方法偏差(必须分开看):
- 因果锚点选错:作者把主因归于”思维遮蔽”,但维护者指出遮蔽是纯 UI、思维仍在发生;且作者自己的数据显示思维深度在 2 月下旬(遮蔽开始前)已降 67%,这与他自己的遮蔽因果论相矛盾。真正对应的官方改动是 3 月 4 日 effort 默认降 medium 与 3 月 26 日的 keep:1 bug,而非遮蔽头本身。
- “思维深度”是代理估算而非实测:0.971 相关是 signature 长度对内容长度的回归推断,遮蔽后无法直接观测思维 token,作者也承认这是估计;官方 API 未暴露
thinking_tokens,外部无法校验。 - 单用户、单操作人、自选择样本:6,852 个会话全部来自作者自己的四个内部项目,没有对照组;行为标签(挫败词、推卸责任)依赖作者自建规则,主观性不可避免。
- 规模扩张与退化浪费未分离:作者自己承认 3 月并发从 1–3 会话扩到 5–10+,是 5–10 倍的合理扩张;80 倍请求、122 倍成本是扩张与抖动重试的叠加,作者拆分出”额外 8–16 倍”属于估算,不是实测。1 月 API 数据本身不完整(缺前 8 天),基线成本 $26 标注为残缺值。
- 成本口径为 Bedrock 公开价估算,非实际账单;订阅制下用户实际只付 $400/月,$42,121 是”若按 API 标价折算”的对比量。
- 时间相关性不等于因果:3 月 8 日遮蔽过半与质量报告同日出现,但 post-mortem 显示三条改动分别在 3/4、3/26、4/16 生效,单条时间线无法解释全程。
六、适用 / 不适用场景与启示
- 重度自主 Agent / 长会话用户:应主动用
/effort high|max或 ULTRATHINK,并关注版本更新中的默认 effort 与上下文清理行为; - 依赖长会话恢复的团队:3 月 26 日那类”闲置清理”bug 说明恢复后失忆可能来自客户端上下文管理,而非模型本身;
- 想做质量回归监控的团队:作者的 stop hook、读:写比、打断率可作为本地 canary 信号,但需多用户对照才能排除个人因素;
- 普通轻量任务用户:medium 默认在速度/成本上的权衡对多数任务合理,此争端主要影响复杂工程流。
七、客观分析:优势与局限
优势: 重度用户用结构化日志把模糊抱怨量化,推动官方公开复盘并重置额度;官方最终承认”错误的权衡”并回滚,形成了可验证的闭环。
局限: 作者的主因果(遮蔽致退化)被官方证据否定,数据又混入规模扩张;官方 post-mortem 的 3% 掉分来自”一次 ablation”,内部评测细节未公开;effort-分数曲线是 Anthropic 内部自主编码评测,外部无法复现;透明度诉求(在 usage 响应中暴露 thinking_tokens)截至该复盘仍未实现。
八、它意味着什么
这场争论的本质是:推理是有成本的,厂商在延迟、限额与智能之间选默认点时,深度依赖思考预算的高级用户无法从外部观测自己拿到了多少思考——遮蔽让退化变得不可见,这才是 issue 标题”透明性”的真正所指。官方复盘证明质量问题确实存在且可修复,但也说明单用户日志的归因需要与工程变更记录互证,不能把时间相关直接写成因果。