celld:Deno 团队把 Cloudflare Durable Objects 搬进自托管环境
阅读时间: 大约 8 分钟
celld:Deno 团队把 Cloudflare Durable Objects 搬进自托管环境
celld 是 deno 团队(denoland)开源的运行时,目标是”Self-hosted, distributed Durable Objects”:让原本只能跑在 Cloudflare 上的 Workers 与 Durable Objects 代码,不改一行跑在你自己的机器上。据 Koala 项目库点评,Durable Objects 是近年最优雅的有状态编程抽象之一,代价是深度锁定 Cloudflare;celld 就是来打破这层锁定的。本文基于官网 celld.dev 梳理。
一、它承诺什么
官网开篇三句话:你的 Cloudflare 应用原样运行(Workers、Durable Objects、KV、Queues、D1、R2、Workflows、Cron、静态资源);数据放在你自己拥有的桶里;规模化后成本低一个数量级。
交付形态极轻:一个 58 MB 的静态可执行文件(curl -fsSL celld.dev/install.sh | sh),或 Docker 镜像 ghcr.io/denoland/celld。它直接读取你现有的 wrangler.json,遇到不认识的 key 会报错停下而不是默默忽略——这点对迁移安全性是加分项。
二、架构:用 S3 桶当分布式协调器
celld 最巧妙的设计是它不要成员协议、不要故障检测器、不要共识服务。做法是:
- 所有 cell(Durable Object/KV/Queue/D1/Workflow 各是一个 cell)状态存在各自的 SQLite 数据库里;
- 节点共享一个 S3 兼容对象存储桶(支持 S3、Google Cloud Storage、Azure Blob)作为持久层;
- 靠**桶的条件写(compare-and-swap)**来仲裁 cell 归属:哪个节点在桶里抢到租约,cell 就归它;
- 状态用 SQLite + Litestream 的 LTX 格式持续复制到桶。
一个 cell 同一时刻只在一个实例上运行(epoch-fenced,每 cell 写者数=1);实例间路由 cell 请求并复制写。某实例挂了,另一个通过 CAS 抢到租约、从存储恢复 cell。
三、官方数据:密度、延迟、故障转移
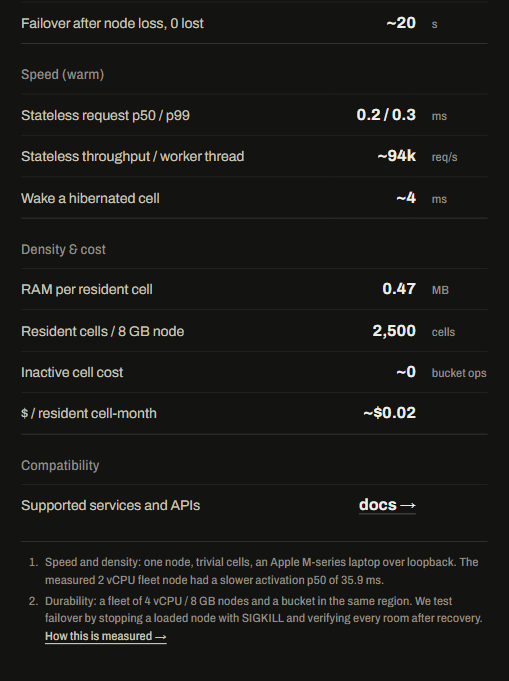
官网”Key characteristics”表给出的数字(均来自官网):
| 维度 | 指标 | 数值 |
|---|---|---|
| 持久化 | 每 cell 写者数(epoch-fenced) | 1 |
| 持久化 | kill 时已确认写丢失 | 0(RPO=0) |
| 持久化 | 持久写延迟(单节点、同区) | ~90 ms |
| 持久化 | 节点宕机后故障转移、零丢失 | ~20 s |
| 速度(热) | 无状态请求 p50 / p99 | 0.2 / 0.3 ms |
| 速度(热) | 每工作线程无状态吞吐 | ~94k req/s |
| 速度(热) | 唤醒一个休眠 cell | ~4 ms |
| 密度成本 | 每常驻 cell 内存 | 0.47 MB |
| 密度成本 | 8 GB 节点常驻 cell 数 | 2,500 |
| 密度成本 | 非活动 cell 桶操作成本 | ~0 |
| 密度成本 | 每常驻 cell-月成本 | ~$0.02 |
成本对比官网也算得很直白:Cloudflare Workers Paid 是 $5/月 + 每个常驻 cell-月 $4.15;celld 用 DigitalOcean us-east $48/月的 8GB 节点,每节点封顶 2,500 个常驻 cell,折算约 $0.02/cell-月——差了两个数量级。
四、兼容面:哪些 Cloudflare 服务能跑
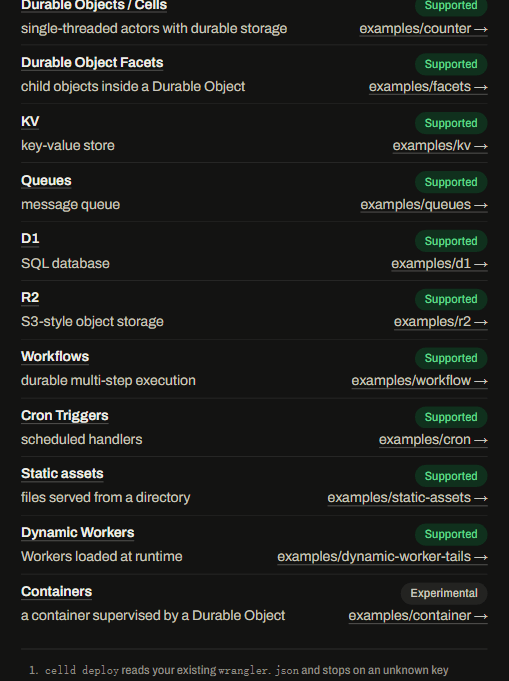
从服务矩阵看,Workers、Durable Objects/Cells、DO Facets、KV、Queues、D1、R2、Workflows、Cron、静态资源、动态 Workers 均标 Supported;Containers 标 Experimental。每个 KV namespace、D1 库、队列、Workflow 都是一个 cell,享有和 DO 一样的租约、SQLite、LTX 复制与故障转移;R2 绑定则直接读写你的桶。
五、口径与局限:数字是怎么测的
官网在表下用脚注主动交代了测量条件,这是评估时必须带上的:
- 速度与密度是”理想环境”:官方写明”one node, trivial cells, an Apple M-series laptop over loopback”——即在苹果 M 系笔记本回环上、跑无关紧要的小 cell 测的。而在”实测的 2 vCPU 机队节点”上,唤醒一个休眠 cell 的 activation p50 慢到 35.9 ms,远高于宣传的 ~4 ms。
- 持久化测试条件:用 4 vCPU/8GB 机队 + 同区一个桶,通过
SIGKILL强杀一个满载节点、恢复后逐个房间校验。这是受控测试,不等于你的生产网络。 - 成本账不含流量:官网明确这些是基础成本,不含应用流量带来的计算与桶用量;超大流量下桶请求费用会改写这笔账。
- 出界范围:官网直说”任何需要 Cloudflare 全球网络、其 GPU、或浏览器农场的能力都不支持”。
- 仍依赖你的基础设施:自托管把命运拿回来,也意味着机队、网络、桶供应商的可用性责任全在你自己身上——blast radius 由你选,但也由你扛。
值得一提的是,官网主动引用了 2026 年 7 月的事件:Orange Cloud Report 给 Cloudflare Durable Objects 的可靠性打了 2/10,并称其”技术上惊艳、运维上可怕”;同月 Cloudflare status 也记录了 DO 错误率上升的重大故障。这正是 celld 讲故事的时机——把可靠性风险从厂商手里搬到自己可控的机队上。
六、客观分析:优势与适合人群
优势: 几乎零迁移成本(读 wrangler.json)、58MB 单二进制好部署、用 S3 桶当协调器省掉了 etcd/ consensus 层、RPO=0 + ~20s 故障转移的有状态语义保持了 DO 的编程模型;成本在大规模常驻 cell 场景下极具竞争力。
适合: 已用 Cloudflare DO、想摆脱厂商锁定或需要数据落自己桶的团队;对成本敏感、常驻 cell 很多的应用;有运维能力、能自己背机队与桶可用性的团队。
注意: 宣传的 ~4ms 唤醒是回环小 cell 数字,生产 2 vCPU 节点实测 35.9ms,别拿前者做容量规划;Containers 仍实验性;自托管不是免费午餐——省了厂商溢价,也接回了运维责任。