Cactus:跑在手机与可穿戴设备上的端云混合 AI 推理引擎
阅读时间: 大约 11 分钟
Cactus:跑在手机与可穿戴设备上的端云混合 AI 推理引擎
Ollama 让”在电脑上跑大模型”变得流行,但手机、手表这类内存和算力都紧张的设备,一直缺一个同类的端侧运行时。Cactus(cactus-compute/cactus)就是冲着这个空白来的——官方把它定位为”面向手机与可穿戴设备的混合边云 AI 引擎”,覆盖 LLM、VLM 视觉理解与 TTS/语音转写,并提供 Swift、Kotlin、Flutter、React Native、Python、Rust 多端绑定。本文基于其 GitHub 官方 README,拆解它的分层架构、实测速度与量化质量代价。
一、是什么:四层自研栈
Cactus 不是对 llama.cpp 的薄薄封装,而是从量化到 API 的一整套自研栈,自上而下分四层:
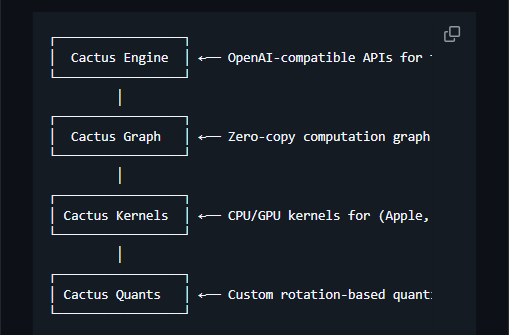
- Cactus Engine(C):对外提供 OpenAI 兼容 API,覆盖文本对话、流式输出、工具调用、语音转写、Embedding、RAG、视觉、向量索引,以及”云交接”(cloud handoff);
- Cactus Graph(C++):零拷贝计算图,负责矩阵乘、注意力、归一化、激活等张量运算;
- Cactus Kernels(C++):针对 Apple、三星、Pixel 等设备手写的 ARM NEON SIMD 内核,覆盖 matmul、注意力、卷积、量化、DSP、图像处理;
- Cactus Quants(C++):自研的旋转加码本(rotation-and-codebook)量化,支持从 4-bit 一直压到 1-bit。
此外还有 Cactus Hybrid(C/Python):根据本地模型的置信度自动把难题路由到云端——一次推理返回的 JSON 里会带 cloud_handoff、confidence(如 0.8193)和 confidence_threshold(如 0.7),低于阈值就自动换手云端模型。这对应了”本地优先 / 云端优先 / 严格本地”三种运行策略。它还提供一个 26M 参数的 Needle 模型专门做端侧工具调用。
这种”每次推理都回吐遥测”的设计值得一提:除了回答文本,一次 cactus_complete 调用还会结构化返回 time_to_first_token_ms(首 token 时延,示例 45.23ms)、prefill_tps(预填充吞吐,示例 1621.89)、decode_tps(解码吞吐,示例 168.42)、ram_usage_mb(示例 245.67)以及 prefill/decode/total_tokens。对端侧 App 来说,这些字段让”本地到底够不够快、什么时候该切云”可以被量化监控,而不是靠用户主观感受。开发者侧的 CLI 也尽量对齐 Ollama 习惯:brew install cactus-compute/cactus/cactus 后 cactus run [HF-Name] 即可,支持 --bits 1|2|3|4|2.54|3.26 选量化档、--backend cpu|metal 选后端、--image 走 VLM、--audio 走语音。
二、关键数据:官方自测速度
官方给出的基准命令是 cactus benchmark,测的是 Gemma-4-E2B-CQ4(1k 上下文预填充、decode 100 tokens、不含推测解码/MTP,纯 decode):
| 设备 | LLM 预填充/解码 (t/s) | VLM 图像编码/解码 | 语音转写 | 1k 上下文峰值内存 |
|---|---|---|---|---|
| Mac M5 Max | 2964 / 154 | 0.09s / 168 t/s | 0.15s | 1348 MB |
| Mac M4 Pro | 1963 / 101 | 0.25s / 112 t/s | 0.21s | 1225 MB |
| Mac M3 Pro | 1294 / 64 | 0.40s / 72 t/s | 0.37s | 735 MB |
| iPad / Vision Pro M5 | 1336 / 71 | 0.25s / 80 t/s | 0.27s | 703 MB |
| iPhone 17 Pro | 729 / 37 | 0.5s / 39 t/s | 0.51s | 644 MB |
| iPhone 15 Pro | 517 / 26 | 1.15s / 27 t/s | 0.82s | 633 MB |
README 还列出几个小模型的解码速度:LFM2.5-VL-1.6B 约 289 t/s、Qwen3-1.7B 约 155 t/s、LFM2.5-VL-450m 约 472 t/s(图像编码 43ms)、LFM2.5-VL-230m 约 555 t/s。从这组数字看,端侧真正可用的是 1B–2B 级别小模型;到 iPhone 15 Pro 上 decode 只有 26 t/s,体验上只够短问答。
三、量化质量:压到 2-bit 会发生什么
Cactus 的卖点之一是支持 CQ2 / CQ3 / CQ4 均匀量化,以及混合精度的 CQ3.26、CQ2.54。官方用 Gemma-4-E2B-it 在多个基准上跑了跨位宽对比(3 个种子取平均):
| 基准 | F16 原始 | CQ4 | CQ3.26 | CQ2.54 | CQ2 |
|---|---|---|---|---|---|
| ARC-E | 73.80 | 73.73 | 74.20 | 68.20 | 50.80 |
| HellaSwag | 46.93 | 47.07 | 45.20 | 40.73 | 35.87 |
| MMLU | 62.33 | 59.45 | 57.63 | 47.19 | 33.18 |
| GSM8K | 73.67 | 71.20 | 66.20 | 22.00 | 0.40 |
| HumanEval | 54.88 | 57.11 | 53.66 | 15.24 | 1.02 |
| BFCL Multi | 89.00 | 88.33 | 89.00 | 52.50 | 13.67 |
这组表很诚实地暴露了极限量化的代价:CQ4 几乎不掉点(HumanEval 甚至略升),CQ3.26 仍可接受,但一旦压到 CQ2.54/CQ2,需要多步推理与代码能力的任务(GSM8K、HumanEval、函数调用)直接崩塌——GSM8K 从 73.67 掉到 0.40,基本等于不会算。也就是说,2-bit 只适合闲聊与简单意图识别,不能碰推理与代码。
四、评测方法的偏向
必须指出这些数字的口径:
- 全部为厂商自测:硬件、模型版本、量化参数都由 Cactus 团队选择,没有与 llama.cpp、MLC-LLM、MNN 等同类端侧引擎的同场对比;
- 明确不含推测解码/MTP:官方特意标注”no speculative decode or MTP, pure decode”,这是为了公平,但也意味着日常开启 MTP 后实际 decode 速度会更高,此表是保守下限;
- 模型转换仍是实验性:README 写明”Any HuggingFace model can be converted…though experimental”,实测支持较好的是 Liquid、Gemma、Whisper、Parakeet、Qwen 几家,并非 HF 上任意模型都能开箱即跑;
- 周报名说”支持 GGUF”,但官方 README 的主路径是
cactus convert转换 HF 权重,GGUF 兼容更多是社区印象,选型时应以官方支持清单为准。
五、优势与局限
优势:
- 全栈自研、端到端可控:从量化算法到 ARM NEON 内核到 OpenAI 兼容 API 一条龙,不依赖第三方推理框架;
- 端云自动分流:用置信度阈值决定本地还是云端,兼顾隐私(本地严格模式)与成功率(云端兜底);
- 多模态一体:LLM/VLM/ASR(Parakeet/Whisper)/TTS 在同一个引擎里,不必拼多个 SDK;
- 绑定齐全:Flutter / React Native 绑定对跨端 App 开发者友好。
局限:
- 手机上跑不大模型:iPhone 15 Pro 上 2B 模型 decode 仅 26 t/s,受内存与功耗硬约束;
- 极限量化伤推理:2-bit 在 GSM8K/HumanEval 上几乎不可用,量化档位要按任务挑;
- 生态年轻:仓库仍有数十个 open issue / PR,模型转换与部分内核处于实验阶段;
- 缺横向对比:没有与 llama.cpp 等成熟端侧方案的 benchmark,性能优势需自行验证。
六、谁该关注
- 做跨端 AI App 的开发者:需要本地优先、离线可用、又能在置信度低时无缝上云的产品,Cactus 的端云混合模型很贴;
- 可穿戴 / 智能家居 / 机器人场景:内存极受限、需要 VLM+ASR 一体的嵌入式推理;
- 追求极致端侧体验且愿意调参的团队:能接受实验性转换、愿意按任务选量化档位;
- 只想”手机上一键跑 GGUF”的普通用户:当前成熟度与模型生态可能不如直接用现成 App,建议观望。