Bonsai 27B:把 27B 大模型塞进手机的 1-bit 压缩实验
阅读时间: 大约 9 分钟
Bonsai 27B:把 27B 大模型塞进手机的 1-bit 压缩实验
2026 年 7 月 14 日,PrismML 发布 Bonsai 27B——一个基于 Qwen3.6 27B 改造、号称”首个能在手机上跑起来的 27B 级模型”。一家由 Caltech 研究人员创立、背后站着 Khosla Ventures、Google、Samsung 等投资方的公司,选择把”端侧智能密度”当作主打卖点。本文回到官方新闻稿与它公布的数据表,看看这个 3.9GB 的小体积到底买到了什么、又丢掉了什么。
一、背景:为什么 27B 以前上不了手机
官方给的理由很直白:一个 27B 模型在 FP16 精度下约占 54GB,即便用常规 4-bit 量化压到 18GB,对手机和大多数笔记本来说仍然太大。这就是端侧部署长期卡住的物理瓶颈——不是模型不够聪明,是装不下。
PrismML 的路线不是”事后量化”,而是端到端低比特训练:权重从一开始就用极低比特表示,贯穿语言网络、embedding、注意力、MLP 直到最后的 LM head,官方强调”没有任何高精度逃生舱口(no higher-precision escape hatches)”。
二、两个版本:质量优先 vs 体积优先
| 版本 | 权重类型 | 有效比特/权重 | 体积 | 定位 |
|---|---|---|---|---|
| Ternary Bonsai 27B | 三值 {-1,0,+1},FP16 分组缩放 | 1.71 bit | 5.9 GB | 质量版,日常笔记本可跑全能力 |
| 1-bit Bonsai 27B | 二值 {-1,+1},同样分组缩放 | 1.125 bit | 3.9 GB | 体积版,塞进 iPhone 17 Pro 内存预算 |
两者都保留完整多模态(视觉塔以紧凑的 4-bit 形式提供)、262K token 上下文、工具调用与计算机操作 agent 循环,并支持 speculative-decoding(无损的 draft-and-verify 加速)。权重以 Apache 2.0 协议发布,可商用;Apple 设备走 MLX、NVIDIA GPU 走 CUDA,配合为其混合注意力架构定制的低比特内核。
三、关键数据:15 项基准的保留率
官方在”思考模式”(充分激发推理)下跑了覆盖知识、推理、数学、编码、指令遵循、工具调用、视觉的 15 项基准。数据如下(左→右:Qwen3.6 27B 全精度 / 三值版 / 1-bit 版):
| 能力类别(基准) | 全精度基线 | 三值版 | 1-bit 版 |
|---|---|---|---|
| 数学(GSM8K, MATH-500, AIME25/26) | 95.3 | 93.4 | 91.7 |
| 编码(HumanEval+, MBPP+, LiveCodeBench) | 88.7 | 86.0 | 81.9 |
| Agent/工具调用(BFCL v3, TauBench) | 80.0 | 74.0 | 66.0 |
| 指令遵循(IFEval, IFBench) | 78.4 | 71.8 | 65.8 |
| 知识/STEM(MMLU-Redux, MuSR) | 83.1 | 77.0 | 73.4 |
| 视觉(MMMU Pro, OCRBench) | 72.6 | 65.2 | 59.6 |
| 总体(15 项) | 85.0 | 80.5 | 76.1 |
官方称三值版保留了全精度基线的 95%,1-bit 版保留 90%。逐行读,故事比平均值更清楚:数学和编码几乎没掉,工具调用离全精度只差几分——正好是 agent 工作流最依赖的能力;而视觉从 72.6 一路掉到 59.6,是掉得最狠的一类。
四、“智能密度”:一个自造指标要怎么读
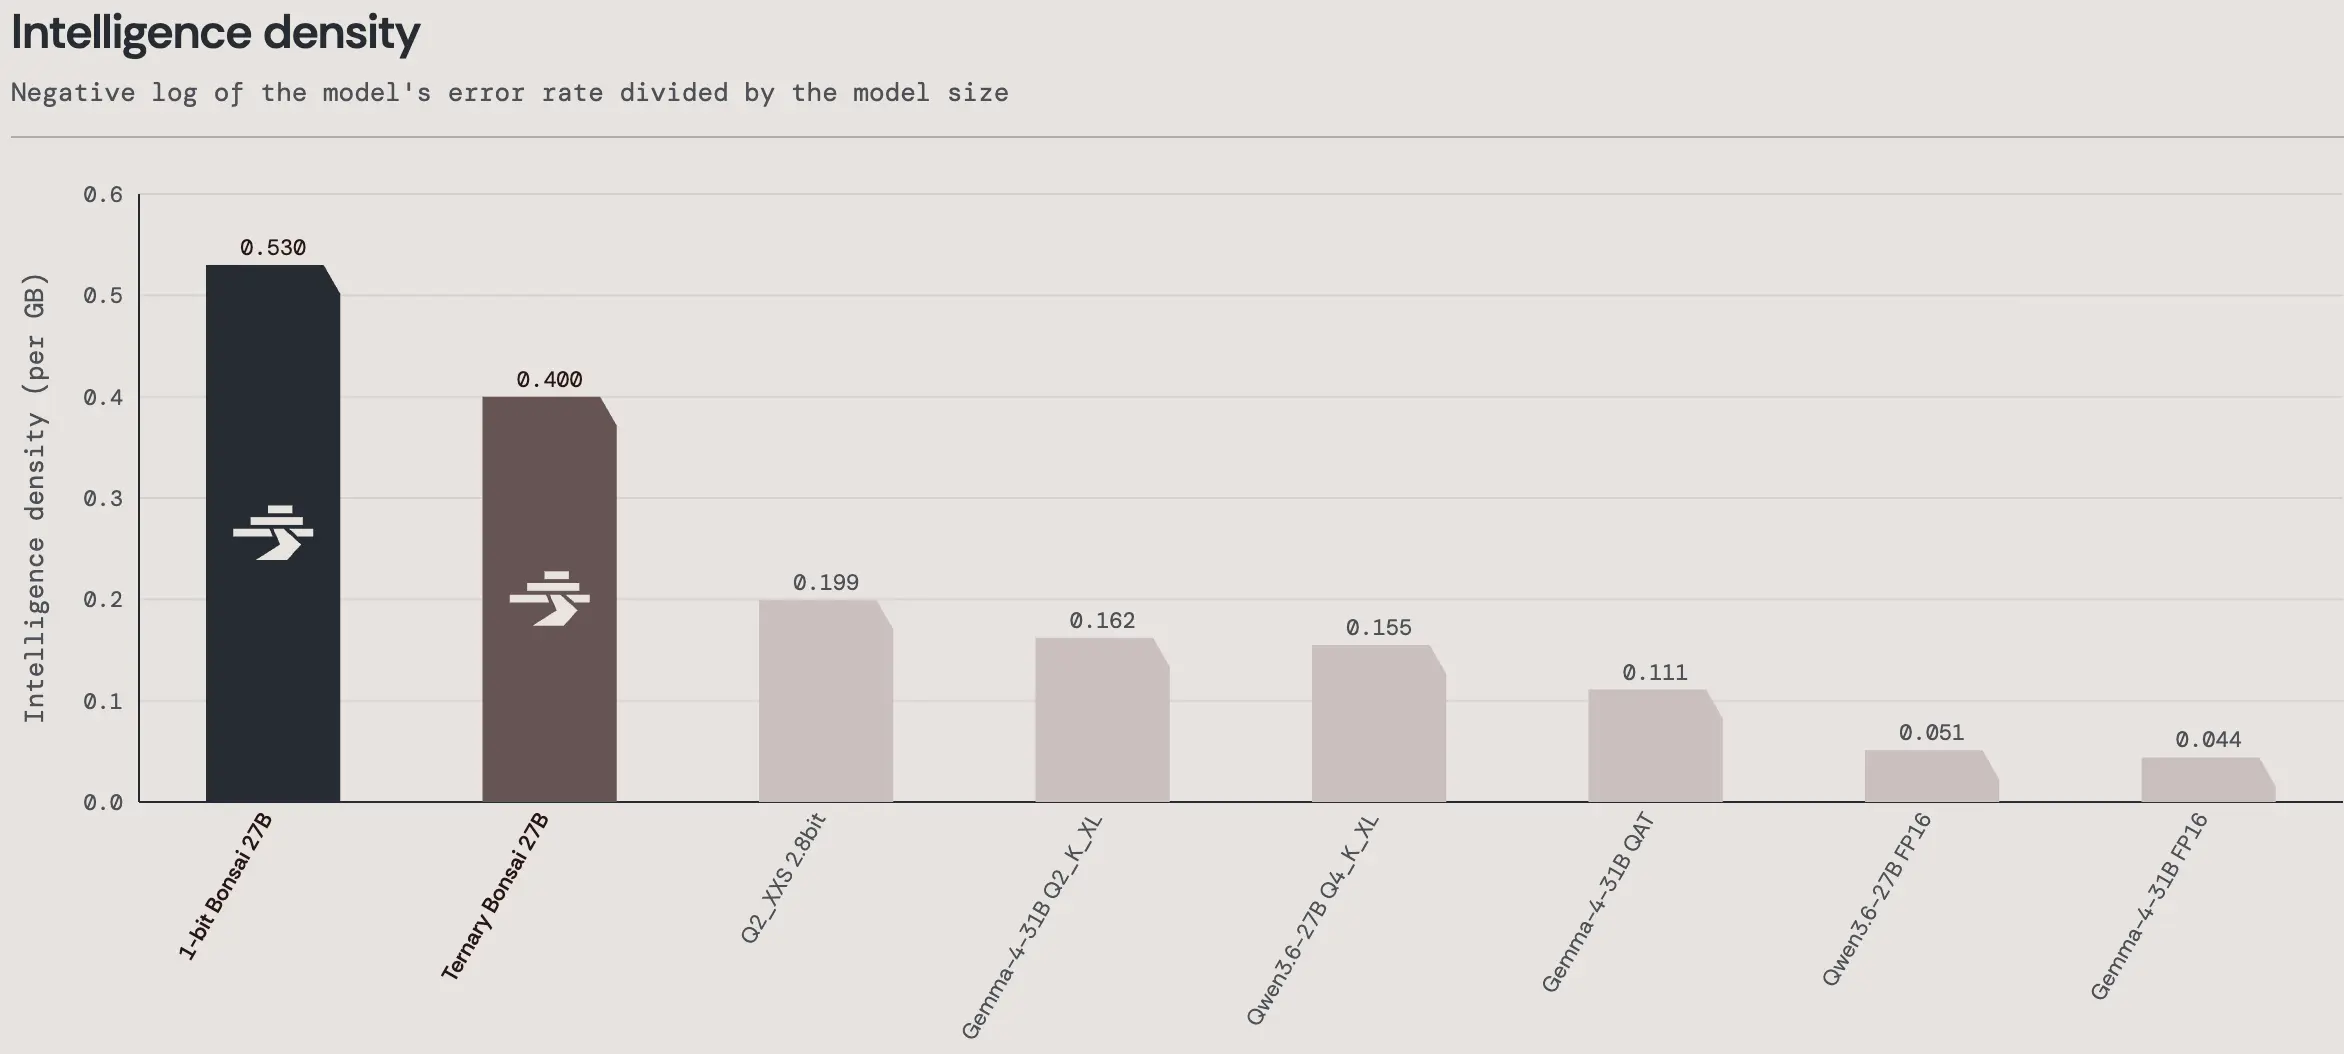
官方主推的概念叫智能密度(intelligence density),定义写在图里:“模型错误率的负对数除以模型体积(每 GB)“。上面那张柱状图就是官方对比(已核实图中数值):
- 1-bit Bonsai 27B:0.530 / GB
- Ternary Bonsai 27B:0.400 / GB
- Q2_XXS 2.8bit:0.199
- Gemma-4-31B Q2_K_XL:0.162
- Qwen3.6-27B Q4_K_XL:0.155
- Qwen3.6-27B FP16:0.051
- Gemma-4-31B FP16:0.044
官方据此宣称 1-bit 版”每 GB 智能是全精度基线的 10 倍以上、约为最佳低比特替代方案的 2.7 倍”。但要注意:智能密度是 PrismML 自己定义、自己挑对比对象的指标,分母是”模型体积”、分子是他们选定错误率的负对数;这是一个营销友好的派生量,不是社区公认的基准。图中对比列里 Q2_XXS、QAT 等对手的测试条件、采样设置是否与 Bonsai 完全一致,官方并未在本页说明,完整细节被推给了未公开链接的 whitepaper。
五、评测口径与必须保留的保留意见
- “95%/90% 保留率”是平均值话术:总体保留率好看,但拆开看视觉掉了 13 个百分点、工具调用掉了 14 个百分点(80.0→66.0)。Koala 周报的点评也直接建议:多模态场景还是用三值版。
- 对比对象未点名:官方只说”同基座最激进的常规低比特方案,占用多 2.5 倍内存但分数显著更低”,没有给出具体模型名与分数,无法独立核对。
- 速度数字来自二手:周报摘要称其在 RTX 5090 上可达 163 token/s,但官方新闻稿正文并未给出该具体吞吐数字(仅展示了 RTX 5090 上跑 agent 工作流的 Demo),此数字应视为待核实。
- 视觉塔单独 4-bit:多模态能力本就受损,视觉塔还被压到 4-bit 以省内存,看截图/文档/摄像头输入时的可靠性要自行验证。
- “无高精度逃生舱口”是双刃剑:意味着不能靠某些层 FP16 来兜底精度,全靠低比特训练本身撑住。
六、适用与不适用
适合:需要在笔记本、手机等端侧设备本地跑一个 27B 级推理/编码 agent、对数据不出设备有硬要求的场景;文本为主、数学与代码密集的 agent 工作流。
不适合:重度视觉/截图理解任务(1-bit 版掉到 59.6,建议至少上三值版);追求绝对顶配智能、不差云端延迟的产品(云 API 仍是更省心选择);需要第三方可复现基准背书的严肃选型——目前只有官方自测。
七、它意味着什么
Bonsai 27B 真正的信号不是”手机能跑大模型”这件事本身,而是竞争轴正在从参数规模转向”每 GB 能装多少能力”。当 27B 级模型能以 3.9GB 落进口袋设备,agent 这种”一次任务调几百次模型”的负载就第一次有了端侧、零边际成本、数据不出设备的可能。但它的短板同样诚实:视觉和工具调用的折损说明,1-bit 还远不是无损万能药。对开发者而言,把它当成一个”端侧编码/数学 agent 引擎”来试,比把它当成”全精度 27B 的无损等价物”要稳妥得多。