Cloudflare AutoRAG:把 RAG 流水线做成全托管服务
阅读时间: 大约 10 分钟
Cloudflare AutoRAG:把 RAG 流水线做成全托管服务
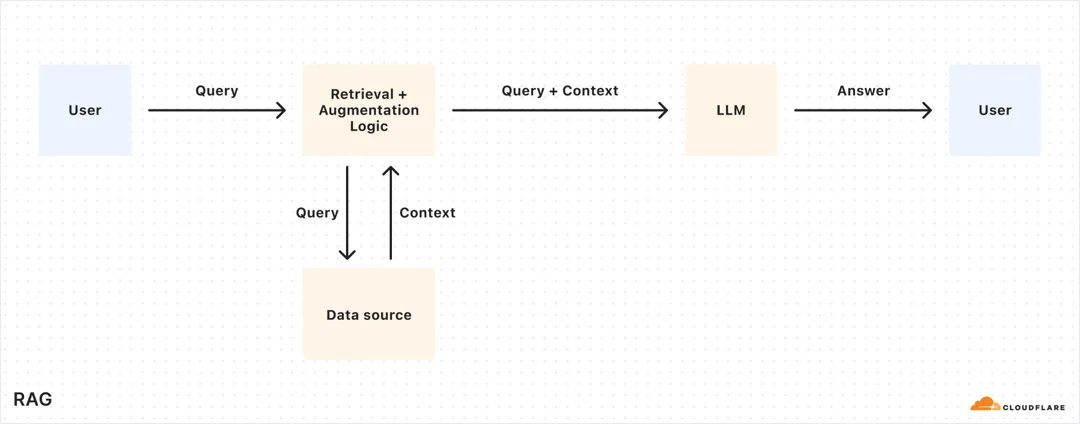
检索增强生成(RAG)是过去两年企业落地大模型最主流的工程范式,但真正把它跑起来并不轻松:你要自己拼对象存储、向量数据库、Embedding 模型、LLM,再手写索引、检索、重排和生成逻辑,数据一变还得手动重建索引。Cloudflare 在 2025 年 4 月 7 日由工程师 Anni Wang 发布了 AutoRAG(开放测试),定位就是把这一整套流水线做成点几下鼠标就能跑起来的全托管服务。本文基于 Cloudflare 官方博客,拆解它的内部机制、计费口径与 beta 阶段的真实边界。
一、为什么需要全托管 RAG
大模型(如 Meta 的 Llama 3.3)只知道训练时见过的内容,面对新增、私有或领域专属信息时容易答错。靠系统提示词硬塞资料会撑爆输入、受上下文窗口限制;微调则成本高、需要持续重训。RAG 的思路是在查询时从你自己的数据源里检索相关片段,连同用户问题一起喂给 LLM,让回答有据可依——这正是客服机器人、内部知识助手、文档语义搜索这类场景的标准做法。
问题在于,自建 RAG 是”一堆移动零件的拼贴”:存储、向量库、Embedding、LLM、自定义索引与检索逻辑,任何一环升级都要自己维护。AutoRAG 的卖点就是把这些零件收敛成 Cloudflare 开发者平台上的一个托管实例。
二、技术机制:索引与查询两条流水线
AutoRAG 背后由两个进程驱动:索引(异步) 与 查询(同步)。
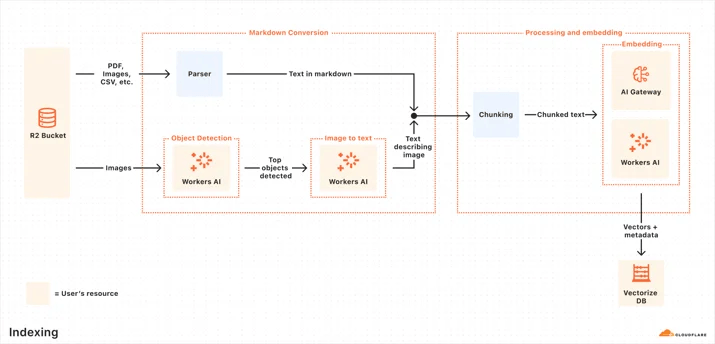
索引流程在创建实例后自动启动,并以循环方式持续重处理新增或变更的文件:
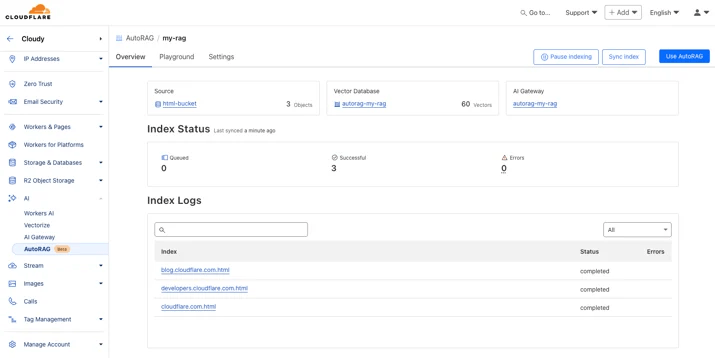
- 数据接入:直接读取数据源,首发只支持 Cloudflare R2 桶,可存放 PDF、图片、文本、HTML、CSV 等;
- Markdown 转换:用 Workers AI 的 Markdown Conversion 把各类文件统一转成结构化 Markdown;图片则先走目标检测(Object Detection),再做视觉转语言(vision-to-language),把图片描述成 Markdown 文本;
- 分块(Chunking):把提取出的文本切成更小片段,提升检索粒度;
- Embedding:用 Workers AI 的 Embedding 模型把每个片段向量化;
- 向量存储:向量连同来源位置、文件名等元数据,写入你账号下自动创建的 Vectorize 数据库。
查询流程在用户发起请求时同步触发:接收查询(走 AI Search 或 Search 端点)→ 可选的查询改写(用 Workers AI 的 LLM 把原始问题改写成更利于检索的形式)→ 用与入库时相同的 Embedding 模型把查询向量化 → 在 Vectorize 中做向量检索 → 取回相关片段与元数据,并从 R2 桶拉回原始内容 → 交给 Workers AI 的文本生成模型产出最终回答。
接入代码非常薄,在 Worker 里通过 AI 绑定直接调用即可:
const answer = await env.AI.autorag('my-rag').aiSearch({ query: 'What is AutoRAG?' });其中 aiSearch() 返回带 LLM 生成的回答,search() 则只返回检索到的片段列表而不生成答案。
三、关键数据与计费口径
| 项目 | 官方口径(开放测试期) |
|---|---|
| 发布时间 | 2025 年 4 月 7 日,开放测试(open beta) |
| 数据源 | 首发仅 Cloudflare R2 桶(PDF/图片/文本/HTML/CSV 等) |
| 向量存储 | 自动创建的 Vectorize 数据库 |
| 模型 | Embedding 与生成 LLM 均可选,官方推荐用 Default |
| 测试期费用 | AutoRAG 本身免费启用 |
| 实际计费 | 底层 R2 / Vectorize / Workers AI / AI Gateway 按正常用量计费 |
| 实例上限 | 每账号 10 个 AutoRAG 实例 |
| 文件上限 | 每个 AutoRAG 最多 100,000 个文件 |
这里有一个必须说清的口径偏差:“测试期免费”不等于”白嫖”。官方明确写道,AutoRAG 实例创建后会在你自己的账号下开通并运行 Cloudflare 资源,这些资源(R2 存源文件、Vectorize 存向量、Workers AI 做图片转写/Embedding/查询改写/生成、AI Gateway 做用量管控)都按正常 Cloudflare 用量计费。AutoRAG 免的是”托管编排”这一层的钱,底层算力与存储账单照常。
四、评测方法与定位的偏向
AutoRAG 官方博客并没有给出任何检索准确率、召回率或端到端延迟的基准数字——它是一篇产品发布与教程文,核心是”5 分钟跑通”,而非性能对比。这意味着:
- 文中没有与 LlamaIndex、LangChain、自建 pgvector 方案的横向 benchmark,“全托管更省心”是定性主张,缺乏量化支撑;
- 索引时间”取决于文件数量与类型”,官方只说可在 Overview 页观察进度,没有给出吞吐数字;
- 查询改写、分块大小等关键质量参数在 beta 期基本是黑盒默认值,官方路线图才提到”递归分块”和”内置重排”,说明当前检索质量仍有明显优化空间。
因此,把它当作”快速验证 RAG 想法的托管起点”是合理的,但据此推断它在生产环境的检索质量优于手工调优的自建栈,则属于过度解读。
五、优势与局限
优势:
- 开箱即用:数据源指向 R2 桶即可,自动建 Vectorize、自动索引、自动增量更新,省去胶水代码;
- 原生云内集成:与 R2、Vectorize、Workers AI、AI Gateway 同账号打通,还能用 Browser Rendering + Puppeteer Worker 把网页爬下来灌进 R2;
- 持续新鲜:索引在后台循环重处理新增/变更文件,不用手动重建 Embedding;
- 双端点灵活:既要答案用
aiSearch,只要检索结果用search。
局限(官方自认或隐含):
- 数据源单一:首发只支持 R2,D1、直接 URL 解析等都在路线图上;
- 缺重排与递归分块:官方明确把”内置 reranking、recursive chunking”列为待办,当前分块与检索质量未做精修;
- beta 配额:每账号 10 实例、每实例 10 万文件,生产规模受限;
- 厂商绑定:整条流水线锁在 Cloudflare 开发者平台上,迁出需要自己重建向量库与索引逻辑;
- 免费仅限编排层:底层 Workers AI / Vectorize 用量随规模上升,成本并不为零。
六、谁该关注
- 想快速搭知识库问答的团队:已经在用 Cloudflare 生态、数据在 R2 里,AutoRAG 能把启动时间从”周”压到”分钟”;
- 做内部知识助手 / 语义搜索的开发者:需要持续索引、不想维护向量库运维的场景;
- 对检索质量要求极高、需要精细调参(重排、混合检索、自定义分块)的团队:当前 beta 能力偏薄,仍建议等路线图落地或继续用可深度定制的自建栈。