Apache Iceberg:给数据湖装上"SQL 表"的开放表格式
阅读时间: 大约 13 分钟
Apache Iceberg:给数据湖装上”SQL 表”的开放表格式
数据湖的痛点一直不是”存不下”,而是”读不对、并发乱、改不动”:Hive 式的分区目录依赖用户手写分区路径,引擎要靠 ls 列目录才能规划扫描,多个作业同时写同一张表容易互相踩踏,schema 一改就要重写整张表。Iceberg 要解决的就是这一整套老问题——它是 Apache 软件基金会下的开放表格式(open table format),起源于 Netflix 内部数据平台,后捐赠给 ASF。本文基于 iceberg.apache.org 官方文档与 Table Spec,拆解它的机制与官方自己标注的口径。
一、背景动机:目录即表的时代该结束了
在 Hive 时代,“一张表”本质上是一套按分区组织的目录结构。这种模式带来三类顽疾:其一,扫描规划依赖列出分区目录,表越大、分区越多,规划越慢,甚至需要分布式 SQL 引擎才能”找到要读哪些文件”;其二,云对象存储(S3 等)是最终一致的,列目录、rename 这类原本假设强一致的操作会出现读到半截、读到旧文件的正确性问题;其三,多引擎、多作业并发写没有一套原子提交约定。Iceberg 的设计目标(官方 Goals 一节)写得很直白:可串行隔离(serializable isolation)、规划只用 O(1) 次远程调用、扩展靠客户端而非中心元数据服务、完整的 schema 与分区演进。
二、是什么:表格式,不是数据库
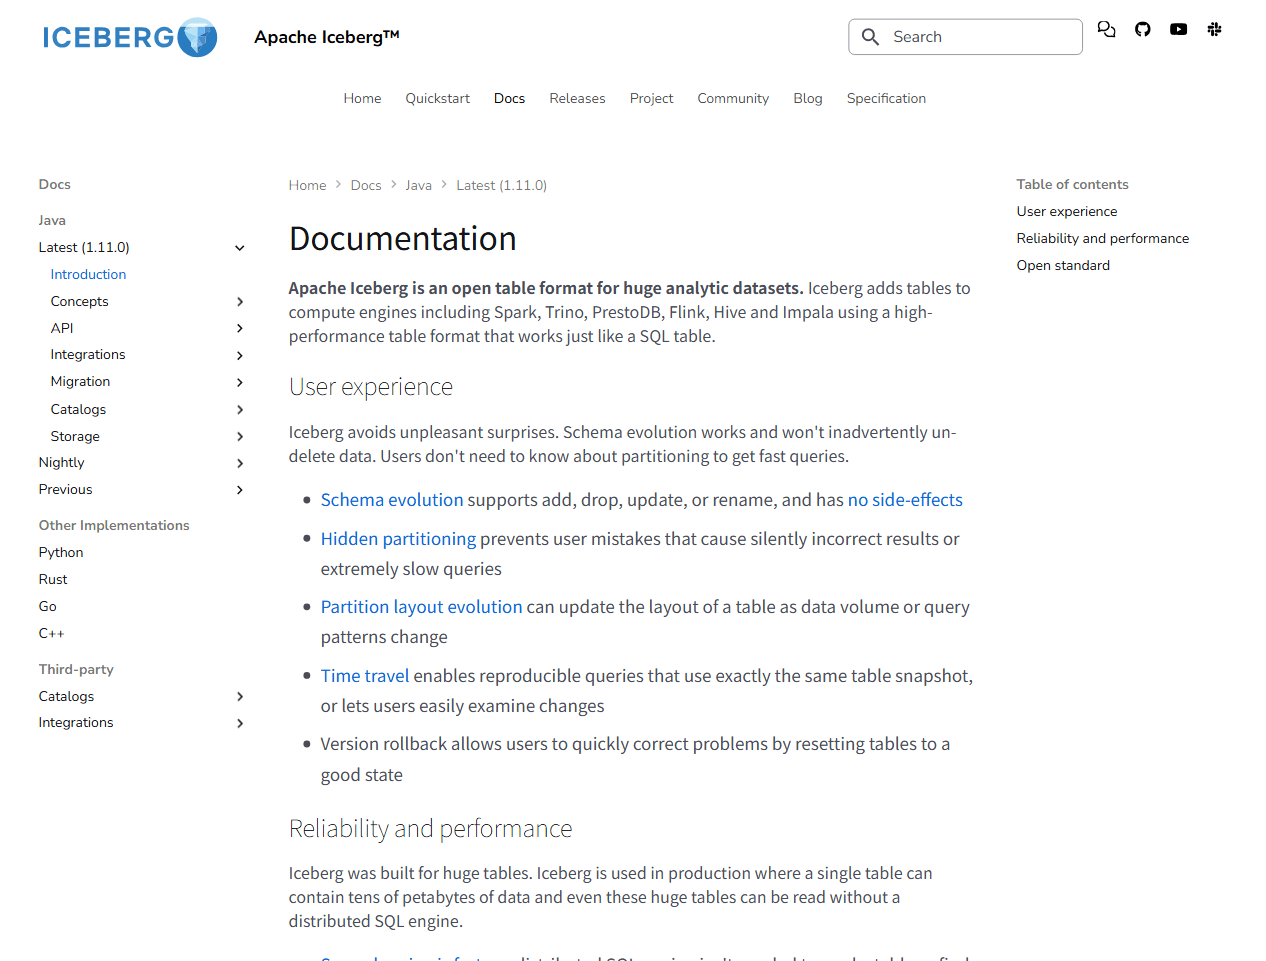
需要先厘清定位:Iceberg 不是一个数据库,也不是一套存储引擎,而是一层”表格式规范”——它规定了数据文件(Parquet/ORC/Avro)与元数据文件如何组织、如何提交。底层数据可以放在任意对象存储、HDFS 甚至本地文件系统上;上层则由 Spark、Trino、PrestoDB、Flink、Hive、Impala 等引擎按同一规范读写。官方文档原话是:“Iceberg adds tables to compute engines … using a high-performance table format that works just like a SQL table.” 换句话说,它把”SQL 表”的可演化、可并发、可时间旅行的体验,搬到了廉价的对象存储之上。
三、技术机制:快照、清单与原子交换
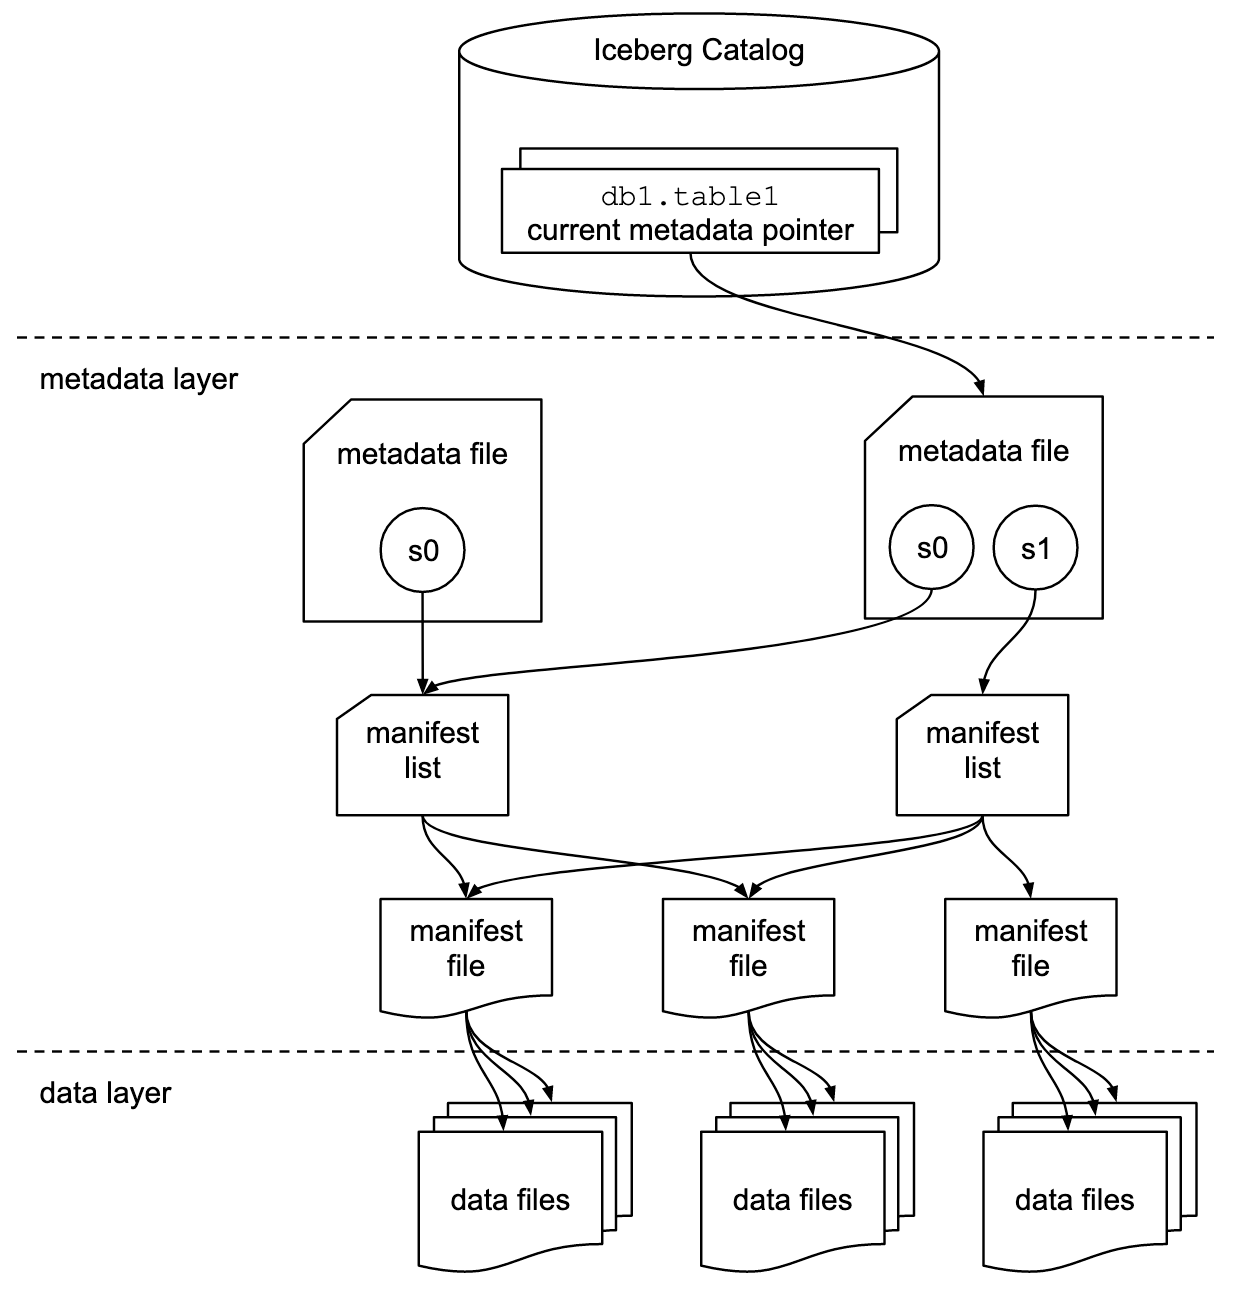
按官方 Table Spec,Iceberg 不跟踪目录,而是逐个数据文件地跟踪。整个结构自上而下是四层:
- Catalog:持有一张表指向”当前元数据文件”的指针(图中
current metadata pointer); - 元数据文件(metadata file):记录表的 schema、分区配置、属性以及一组快照(snapshot)。每次提交都会生成新的元数据文件,再用一次原子替换把目录里的指针切过去——旧文件不删,因此天然保留历史;
- 快照(snapshot)与 manifest list / manifest file:一个快照代表”某一时刻表的完整数据文件集合”。快照不直接罗列所有文件,而是先指向一份 manifest list,再由若干 manifest file 每行记录一个数据文件的分区值、路径、列级统计(min/max/null count 等);
- 数据文件(data files):真正的 Parquet/ORC 数据,存放在对象存储上。
这套结构带来几个关键能力:
- 隐藏分区(hidden partitioning):用户写查询时不需要知道、也不需要手写分区表达式,Iceberg 用数据值上的谓词去剪掉不需要的 manifest 与文件,避免了”分区写错导致静默错误结果或全表扫描”;
- schema 演进零重写:加列、删列、重命名、调整顺序都通过元数据变更完成,官方强调加列”不会让已删除的数据复活”(no zombie data),且不需要重写数据文件;
- 时间旅行与回滚:因为每个快照都是不可变的,
FOR VERSION AS OF/FOR TIMESTAMP AS OF可以复现一次历史查询,出问题时也能把指针回滚到某个好的快照; - 行级删改:v2 起支持
MERGE INTO、UPDATE、DELETE,可以用 equality delete、position delete 或 deletion vector,不必整文件重写; - 数据压缩(compaction):官方内置
rewrite_data_files这类存储过程,支持 bin-packing(合并小文件)与 sorting(按键排序)等策略。
四、关键数据:官方口径
下表均来自官网文档与规范自述:
| 项目 | 官方口径 |
|---|---|
| 定位 | 开放表格式(open table format),非数据库 |
| 兼容引擎 | Spark、Trino、PrestoDB、Flink、Hive、Impala |
| 单表规模 | 官方称生产中单张表可达”数十 PB(tens of petabytes)” |
| 扫描规划 | 官方称 O(1) 次远程调用即可规划文件,“读表/找文件不需要分布式 SQL 引擎” |
| 提交隔离 | 可串行隔离(serializable isolation),读不加锁,写原子可见 |
| 并发写 | 乐观并发控制(optimistic concurrency),冲突时自动重试兼容提交 |
| 行级删改格式 | equality delete、position delete、deletion vector |
| 当前文档版本 | Latest 1.11.0(文档页标注) |
| 格式版本演进 | v1 分析型表 → v2 行级删 → v3 扩展类型 → v4 元数据结构与表示 |
| 底层存储 | 任意云对象存储、HDFS;并能减少 HDFS 的 NameNode 压力(避免列目录与 rename) |
五、评测与口径偏差:哪些数字要打折
这是最需要保持清醒的一节:
- “O(1) 远程调用”指的是扫描规划阶段,不是整条查询的执行时延。它说的是”要读哪些文件”这个决策不再随表规模线性膨胀,而不是”查询本身快”。真正的执行性能仍取决于数据文件布局、压缩与裁剪率;
- “单表数十 PB”是生产使用陈述,不是受控 benchmark。官方没有给出硬件、作业类型、查询 QPS 或 P99 时延,这个数字用来证明”撑得住规模”,不能直接当作”你的表也能这么快”的承诺;
- “不需要分布式 SQL 引擎就能读表”有前提:指的是规划文件这件事可以由客户端完成(甚至 DuckDB 这类单机引擎也能读 Iceberg 表),不等于任何引擎都能高效扫数十 PB 数据;
- 隐藏分区是设计保证,不是免费午餐:分区布局需要随数据量与查询模式演进(partition evolution),小文件过多、快照堆积都要靠定期 compaction 与快照过期治理,这些运维责任落在使用者身上;
- 规范开放 ≠ 零运维:你仍需选型并运维一个 Catalog(Hive Metastore、REST Catalog、JDBC、Nessie 等),Catalog 的可用性与一致性直接关系到表能否被安全并发读写。
六、适用 / 不适用场景
适用: 已经在 S3/OSS 等对象存储上攒了 PB 级分析数据,需要被 Spark、Flink、Trino/Presto 等多引擎共享读写;正在从 Hive 表迁出、受困于分区目录与并发写;需要时间旅行、回溯、行级更新的湖仓(Lakehouse)场景;希望以中立开源格式锁定数据、避免被某一引擎或云厂商绑定。
不适用: 数据量很小、单库就能搞定的业务,上 Iceberg 属于过度工程;需要低时延点查、事务型 OLTP 的系统——它面向分析负载,不是在线交易数据库;没有专业数据平台团队、也不愿承担快照治理与 Catalog 运维的中小团队,陡峭的学习曲线与运维复杂度会先压垮他们。
七、客观分析:优势与局限
优势:
- 正确性优先:针对最终一致的云对象存储设计,原子提交 + 快照让并发读写与回溯有了硬保证;
- 多引擎中立:同一套表格式被主流分析引擎共同支持,避免了格式锁定;
- 元数据解耦数据:演进、时间旅行、行级删改都靠元数据与增量文件完成,不必重写全表;
- 开放规范、跨语言实现:除 Java 外还有 Python、Rust、Go、C++ 实现与 REST Catalog 协议,生态在快速扩张。
局限(官方自认或隐含):
- 学习与运维门槛陡:隐藏分区、分区演进、快照保留、compaction 调优是一套专业知识,中小团队容易踩坑;
- 不是银弹:小文件治理、快照膨胀、删除文件合并都需要周期性维护,“装上去就快”是误解;
- 依赖 Catalog:表的元数据指针在 Catalog 里,Catalog 本身成为必须高可用运行的基础设施;
- 与 Delta Lake、Hudi 同场竞争:Iceberg 的中立性是优势,但格式之争仍在持续,落地前仍需结合团队已有技术栈评估迁移成本。
八、它意味着什么 / 谁该关注
Iceberg 的意义在于把”表”这个抽象从计算引擎里抽了出来,变成一层引擎中立、可演化、可时间旅行的开放规范——这正是 Lakehouse 路线的地基。对已经在对象存储上沉淀数据、且有专业数据团队的组织,它是当下最值得评估的表格式;但对中小规模需求,它带来的复杂度可能超过收益。判断标准很实际:你是否真的有多引擎并发读写、行级更新、回溯审计这类硬需求,以及是否养得起一支会治理快照与分区的数据平台团队。