Airweave:给 AI Agent 接上「任意应用」的开源检索层
阅读时间: 大约 9 分钟
Airweave:给 AI Agent 接上「任意应用」的开源检索层
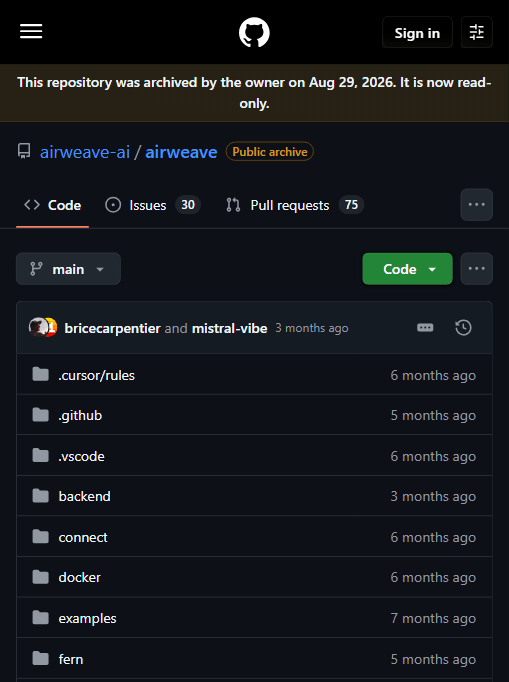
做过 RAG 的人都知道,真正耗时间的不是「怎么搜」,而是「怎么把散落在各处的数据源不断、稳定、带权限地接进来」。Airweave 的定位就是把这件事抽成一层共享基础设施:连接你的应用、工具和数据库,持续同步它们的数据,再通过一个统一的、对 LLM 友好的搜索接口暴露出去。AI Agent 一次请求就能从多个来源取回相关、有据、最新的上下文。需要提前说明的是:根据其 GitHub 仓库页面公告,该仓库已于 2026 年 8 月 29 日被所有者归档为只读,本文所述为归档时的项目状态。
一、它要解决什么问题
传统做法里,每接一个 Agent、每做一个集成,开发者都要重写一套脆弱的数据管道:OAuth 鉴权、增量抓取、格式解析、向量化索引、同步调度。Airweave 把这些一次性包掉,让「检索」成为多个 Agent 共享的中间层,而不是每个应用各写各的。
它在架构里的位置被官方描述得很清楚:夹在「数据源」和「AI 系统」之间,作为共享检索基础设施,负责认证、摄取(ingestion)、同步、索引和检索。Agent 侧通过 SDK、REST API、MCP 或主流 Agent 框架的原生集成来查询它。
二、技术机制与技术栈
根据仓库 README 披露的技术选型:
| 层次 | 选型 |
|---|---|
| 前端 | React / TypeScript + ShadCN |
| 后端 | FastAPI(Python) |
| 元数据库 | PostgreSQL |
| 向量库 | Vespa |
| 任务编排 | Temporal(Worker) |
| 消息 | Redis(pub/sub) |
| 部署 | Docker Compose(开发)/ Kubernetes(生产) |
这套选型有几个值得注意的点。其一,向量检索没有走流行的 PostgreSQL 扩展(如 pgvector)或轻量方案,而是直接上 Vespa——这是 Yahoo 开源的通用搜索引擎,适合大规模、多字段、近实时检索,说明项目瞄准的是「生产级搜索」而非玩具 demo。其二,同步编排交给 Temporal,意味着数据连接器的抓取、重试、状态持久化是按工作流(workflow)方式管理的,比简单的 cron 健壮得多。其三,前后端语言栈分离(Python 后端 + TS 前端),与它开源的语言占比一致。
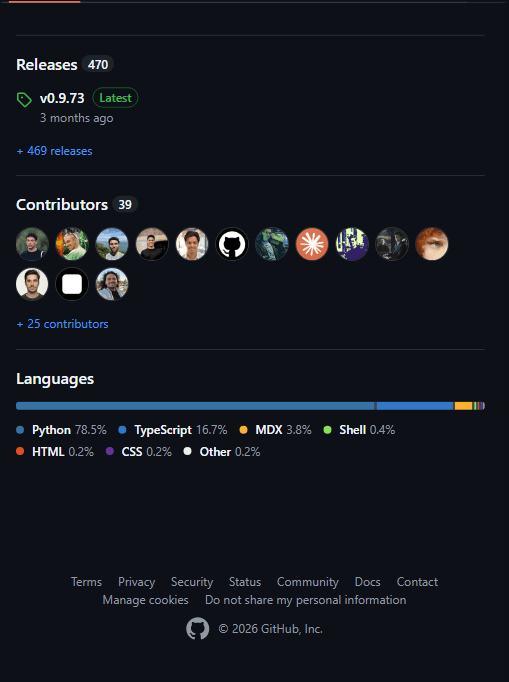
从仓库统计看,归档前它是一个相当活跃的项目:累计 470 个 Release,归档时最新为 v0.9.73(约 3 个月前);39 位贡献者;代码语言占比为 Python 78.5%、TypeScript 16.7%,与上表技术栈完全吻合。
三、接入方式:SDK、CLI 与 MCP
Airweave 同时提供了多种消费方式,对开发者和对 Agent 都友好:
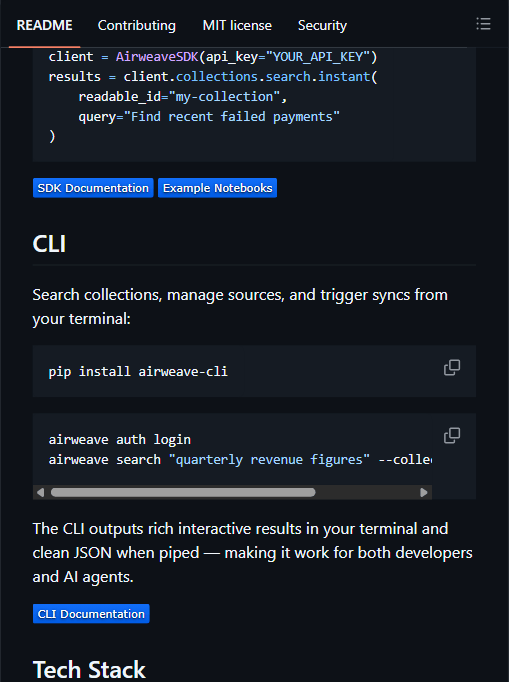
- Python SDK:
pip install airweave-sdk,核心调用形如client.collections.search.instant(readable_id=..., query="Find recent failed payments"); - TypeScript SDK:
npm install @airweave/sdk; - CLI:
pip install airweave-cli,支持在终端搜索 collection、管理数据源、触发同步,且输出既能人读、也能管道成 JSON 给 Agent 用; - MCP 兼容接口:可被快速接入各类支持 MCP 的 AI 应用;
- REST API 与主流 Agent 框架原生集成。
部署上,官方提供两条路:托管版直接用 app.airweave.ai;自托管则 git clone 后运行 ./start.sh,访问 http://localhost:8080,前置依赖只有 Docker 与 docker-compose。协议为 MIT,可自由二次开发。
四、数据源覆盖面
README 称支持 50+ 集成(Koala 项目库当时记为 25+,说明数量在持续增长)。从仓库内的连接器图标可以看到的典型来源包括:Airtable、Asana、Bitbucket、Box、cal.com、ClickUp、Coda、Confluence、Dropbox、Gmail、Google Calendar / Docs、GitHub、GitLab、Intercom、FireFlies、Freshdesk、Zoom 等,基本覆盖了 SaaS、协作、研发与客户沟通这几类高频数据源。
五、评测方法与口径说明
需要清醒看待的是:Airweave 仓库本身没有给出任何独立的检索质量基准、延迟数字或召回率对比。它的「50+ 集成」「生产级架构」属于能力声明,而非效果证明。Vespa + Temporal 的组合在工程上是成熟的,但「能同步多少源」与「检索出来的上下文对 Agent 到底好不好用」是两回事——后者高度依赖切分策略、权限过滤和同步新鲜度,官方文档未公开这部分的实测数据。因此本文不引用任何「性能领先」类表述,只陈述可核对的架构与工程事实。
六、最重要的局限:项目已被归档
这是使用前必须知道的硬约束。GitHub 公告明确写着「This repository was archived by the owner on Aug 29, 2026. It is now read-only」。归档意味着:
- 代码不再接受新提交、Issue 与 PR(归档时仍有 30 个 open Issue、75 个 open PR 未处理完);
- 后续不会再有官方 bug 修复、安全补丁与新连接器;
- 虽然托管版 app.airweave.ai 可能仍在运营,但开源侧的生态已经冻结。
对想自托管并长期依赖的团队,这等于把「维护责任」完全转移到了自己身上——你可以 fork 后继续维护,但要接受没有上游的现实。
七、适用与不适用
适合:
- 想快速给 Agent 接多个 SaaS / 数据库、又不想自己写一堆 OAuth 与同步管道的团队;
- 需要自托管、看重 Vespa 这种成熟搜索引擎与 Temporal 工作流健壮性的场景;
- 愿意把项目 fork 下来自行维护、或主要使用其托管版的用户。
不适合:
- 期望上游持续迭代、长期安全更新的生产关键系统——归档状态下这一前提已不存在;
- 只需要一两个数据源的简单场景,为一套 Vespa + Temporal + Redis 的全栈付出运维成本并不划算;
- 对检索质量有严格要求、需要第三方基准背书的团队——目前缺乏这类证据。
八、它意味着什么
Airweave 代表了 2025–2026 年间很典型的一类「RAG 基础设施」创业方向:不做模型,不做 Agent,只做「把企业数据接进来并持续喂给任意 Agent」的中间层。它的技术选型相当扎实,但项目被官方归档这件事本身也说明:这一赛道竞争激烈、商业化压力大,开源项目的生命周期可能比预期更短。对读者而言,它更适合作为架构参考和可 fork 的工程模板来研究,而不是毫无保留地直接押注到长期生产环境。